
「データ解析のための統計モデリング入門」 読書メモ一覧 - jiku log
はじめに
数理統計学より実践的な内容の理解に向けて,久保 拓弥 著「データ解析のための統計モデリング入門 一般化線形モデル・階層ベイズモデル・MCMC」を読み,第9章「GLMのベイズモデル化と事後分布の推定」の読書メモをまとめた。
stern-bow.hatenablog.com
このときはCmdStanPyを用いて実装した。
このたびNumPyroを学んだので,本章の内容をPythonコードで書き直した。
- 参考サイト
第9章 GLMのベイズモデル化と事後分布の推定
GLMのベイズモデル化
本章で扱う手法は,一般化線形モデル(GLM)のうち,ポアソン回帰である。
ポアソン回帰モデルのGLMでは,個体の種子数
が,平均
のポアソン分布
にしたがうとする。
また線形予測子とリンク関数を用いて,であらわす。
ベイズモデル化するので,パラメータは定数ではなく確率分布
となる。
そして,分析の目的は,データが与えられたときのパラメータの事後分布
を求めることである。
NumPyroによる事後分布の推定の流れ
NumPyroを用いて事後分布を推定する流れは以下のようになる。
- Step 1. パッケージを読み込む。
- Step 2. データを読み込む。
- Step 3. データを整形する。
- Step 4. NumPyroでモデルを定義する。
- Step 5. MCMCを実行する。
- Step 6. 収束判定を行なう。
- Step 7. 事後分析を行なう(可視化など)。
今回は手元のPC(メモリ:16GB,コア数:10)で行なった。Pythonは,Python3.12.6を用いた。使用したライブラリ群は以下の通りである。
arviz     : 0.22.0
jax       : 0.10.1
matplotlib: 3.10.9
numpyro   : 0.21.0
pandas    : 3.0.3
seaborn   : 0.13.2
以下に,使用したコード群を説明する。
Step 1. パッケージを読み込む。
MCMC実行用など,各種パッケージを読み込む。
コード:
# -------------------------------
# パッケージの読み込み
# -------------------------------
# データ処理一般用
import pandas as pd

# NumPyroによるMCMC実行・可視化用
import jax
import jax.numpy as jnp
import numpyro
import numpyro.distributions as dist
from numpyro.infer import MCMC, NUTS, Predictive
import arviz as az

# 可視化用
import matplotlib.pyplot as plt
import seaborn as sns
sns.set_style(style='darkgrid')

# 計算環境の設定
numpyro.set_platform('cpu') # CPUで動作させる。
numpyro.set_host_device_count(4) # 4チェーン並列実行のため、デバイス数を設定
Step 2. データを読み込む。
データを読み込む。なおデータは,https://kuboweb.github.io/-kubo/ce/IwanamiBook.html のdata3a.csvをダウンロードして利用する。
コード:
# -------------------------------
# データの読み込み
# -------------------------------
file_path = "data3a.csv"
df = pd.read_csv(file_path)

print(df.head(3))
print(df.describe())
出力:
   y     x  f
0  6  8.31  C
1  6  9.44  C
2  6  9.50  C
                y           x
count  100.000000  100.000000
mean     7.830000   10.089100
std      2.624881    1.008049
min      2.000000    7.190000
25%      6.000000    9.427500
50%      8.000000   10.155000
75%     10.000000   10.685000
max 15.000000 12.400000データは列は,y,x,fであるが,今回利用するのはyとxである。
Step 3. データを整形する。
NumPyroでデータを扱うために,JAXのjax.numpy モジュールを用いて,データを変換する。
コード:
# -------------------------------
# デザイン行列の作成
# -------------------------------
X = jnp.array(df["x"].values)
y = jnp.array(df["y"].values)
Step 4. NumPyroでモデルを定義する。
ここが1つ目の重要ポイントである。事後分布を求めるので,
- 事前分布
- 尤度
- 線形予測子
- リンク関数
を設定する。
また,尤度の設定において重要なのは,numpyro.plate である。
このクラスは,サンプリングの際に条件付き独立になることを指定している。
コード:
# -------------------------------
# モデル定義
# -------------------------------
# ポアソン回帰モデル
def poisson_reg_model(X, y=None):
    N = len(X)

    # 事前分布
    beta_1 = numpyro.sample("beta_1", dist.Normal(0, 100))
    beta_2 = numpyro.sample("beta_2", dist.Normal(0, 100))

    # 線形予測子
    eta = beta_1 + beta_2 * (X - jnp.mean(X))

    # リンク関数
    mu = jnp.exp(eta)

    # 観測モデル(尤度)
    with numpyro.plate("data", N):
        numpyro.sample("obs", dist.Poisson(mu), obs=y)
Step 5. MCMCを実行する。
ここが2つ目の重要ポイントである。MCMCを実行する際には,以下の手順で進める。
- 乱数の設定
- MCMCの手法の設定(今回はNUTSを使用する。)
- MCMCの実施条件の設定
- バーンイン期間の設定(
num_warmup) - バーンイン後のサンプル数(
num_samples)
- バーンイン期間の設定(
- MCMCの実行
コード:
# -------------------------------
# MCMC実行
# -------------------------------
rng_key = jax.random.PRNGKey(1)
kernel = NUTS(poisson_reg_model)

mcmc = MCMC(
    kernel,
    num_warmup=1000,
    num_samples=1000,
    num_chains=4,
    progress_bar=True
)

mcmc.run(
    rng_key,
    X=X,
    y=y
)
Step 6. 収束判定を行なう。
これが3つ目の重要ポイントである。
収束については,How to Diagnose and Resolve Convergence Problems – Stan に詳しく説明されている。
収束の判定の際には,以下を確認する。
- Rhat
- 1.01以下であれば,得られたサンプルを信頼してもよい。
- トレースプロット
- サンプルの遷移が発散していなければ,得られたサンプルは信頼してもよい。
コード:
# -------------------------------
# 収束判定
# -------------------------------
print("\nMCMCサマリー:")
mcmc.print_summary(prob=0.95)

# MCMCサンプルをArviZ InferenceDataオブジェクトに変換し、プロットしやすくする
idata = az.from_numpyro(mcmc)

# トレースプロット ------------------------------------------------------------
az.plot_trace(idata)
plt.tight_layout()
plt.show()
出力:
MCMCサマリー:

                mean       std    median      2.5%     97.5%     n_eff     r_hat
    beta_1      1.28      0.37      1.27      0.61      2.03    549.79      1.00
    beta_2      0.08      0.04      0.08      0.00      0.14    553.83      1.00

Number of divergences: 0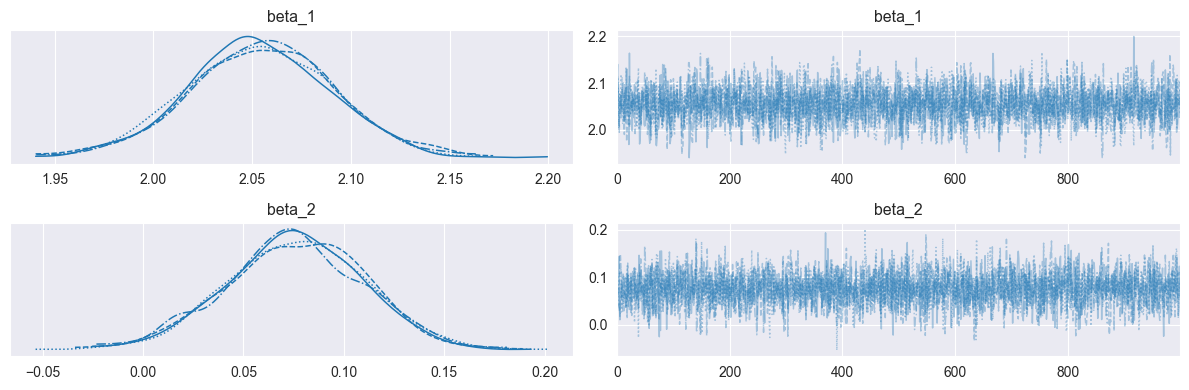
Step 7. 事後分析を行なう(可視化など)。
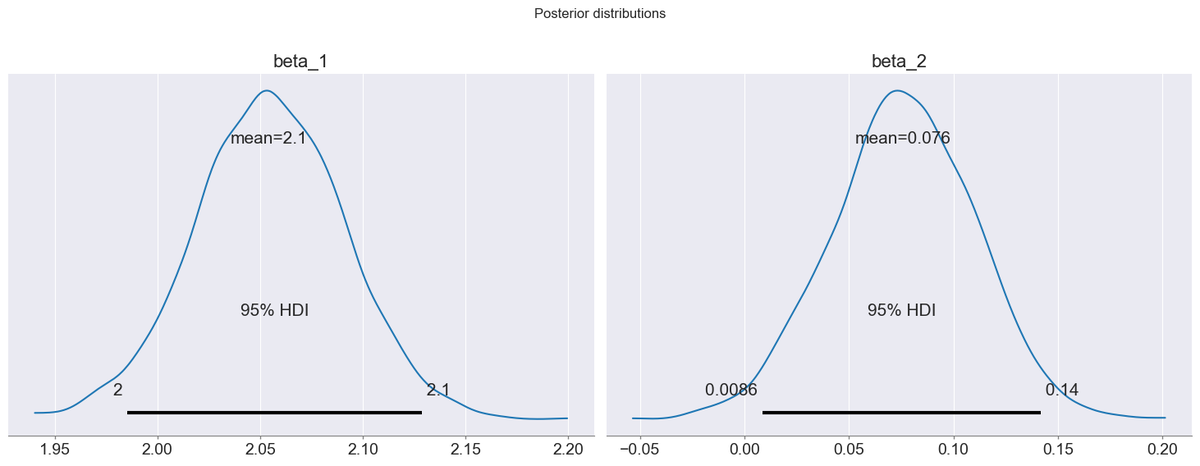
得られたパラメータの事後分布を確認する。95%の最高密度区間(HDI)を可視化すると以下のようになる。
コード:
# -------------------------------
# 可視化
# -------------------------------
# 最高密度区間の表示
print("\nGenerating posterior plots...")
az.plot_posterior(idata, hdi_prob=0.95)
plt.suptitle('Posterior distributions', y=1.02)
plt.tight_layout()
plt.show()
出力:
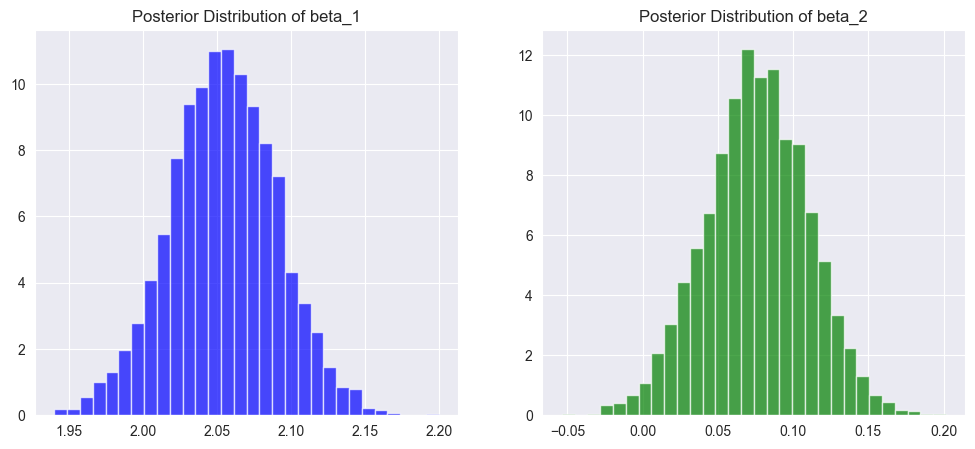
また,事後分布に関するサンプルを取得し,ヒストグラムで表示してもよい。
コード:
# -------------------------------
# 可視化
# -------------------------------
posterior = mcmc.get_samples()

beta_1_samples = posterior["beta_1"]
beta_2_samples = posterior["beta_2"]

plt.figure(figsize=(12, 5))

# 切片beta_1の事後分布
plt.subplot(1, 2, 1)
plt.hist(beta_1_samples, bins=30, density=True, alpha=0.7, color='blue')
plt.title("Posterior Distribution of beta_1")

# 回帰係数betaの事後分布
plt.subplot(1, 2, 2)
plt.hist(beta_2_samples, bins=30, density=True, alpha=0.7, color='green')
plt.title("Posterior Distribution of beta_2")

plt.show()
出力:
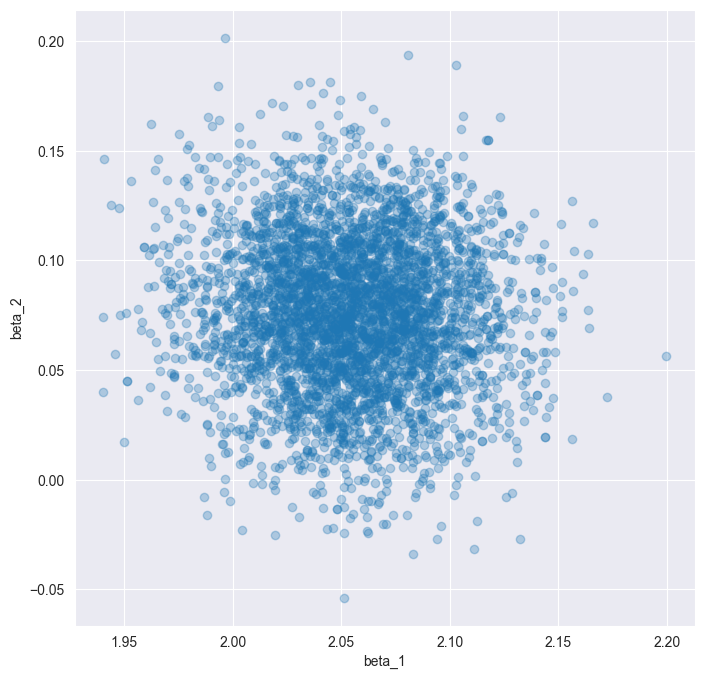
散布図は以下のようになる。
コード:
plt.figure(figsize=(8, 8))

plt.scatter(beta_1_samples, beta_2_samples,alpha=0.3)
plt.xlabel("beta_1")
plt.ylabel("beta_2")
plt.show()
出力:
まとめと感想
NumPyroによるベイズ統計モデリングの流れ
今回は,過去にCmdStanPyで実装したコードをNumPyroに実装しなおした。その際に,NumPyroによるベイズ統計モデリングの流れを整理した。
NumPyroにかぎらず,ベイズ統計モデリングのコア部分は,
- NumPyroでモデルを定義する。
- MCMCを実行する。
- 収束判定を行なう。
である。
NumPyroの場合,モデルの定義はPythonの関数で扱う。Stanの場合,この部分はStanの言語で扱う必要があるので,言語の切り替えが必要ない点がNumPyroの良い点だと感じた。
ただ,実務において重要なのは,分析が上手くいかなかったときにリカバリープランを考えることである。
今後は,分析のPDCAを回せるよう,実務の実施と理論の学習を繰り返していきたい。
本記事を最後まで読んでくださり,どうもありがとうございました。

