
はじめに
藤原 幸一 著「スモールデータ解析と機械学習」は,サンプル数が少ない状況でのモデル構築や予測精度の確保,統計的な不確実性の扱い方など,現場で直面する悩みに直結する理論と実践がコンパクトにまとまっている。製造業のデータ解析において「少ないデータだから仕方ない」と諦めるのではなく,「少ないからこそできる工夫」を身につけるためにこの本を読み,その学びをブログで共有しようと思う。
本記事は,「第5章 分類問題と不均衡データ問題」における,アンサンブル学習に関する読書メモである。
5.12 アンサンブル学習
アンサンブル学習は,弱分類器とよばれる複数のモデルを学習させて,その複数のモデルの結果を統合するという集団学習と呼ばれる方法である。
アンサンブル学習は,クラスのサンプル数が均衡している通常のデータ解析でも用いられるが,不均衡データの解析にも使われることがある。これは,アンサンブル学習の方が,不均衡データでも比較的良い性能を達成しやすいとされているためである。
5.14 バギングとランダムフォレスト
バギング
バギング(bagging)とは,ブートストラップ・アグリゲーティング(bootstrap aggregating)の略である。
バギングは,
- データから一部のサンプルを復元抽出で取り出す(ブートストラップ)。
- 取り出したデータで弱分類器を学習する。
- 最終的に分類結果を統合する。
という手順で学習する。
ランダムフォレスト
ランダムフォレスト(random forest)は,弱分類器として判別木を用いるアンサンブル学習手法である。
判別木のアルゴリズムの1つであるCARTでは,ジニ不純度の改善度を
番目の変数の重要度とした。ランダムフォレストでは,学習させた
個のCARTの改善度から,
番目の変数の重要度
を
このランダムフォレストの変数重要度は,機械学習モデルの変数選択の規準としても用いることができる。
5.15 ブースティング
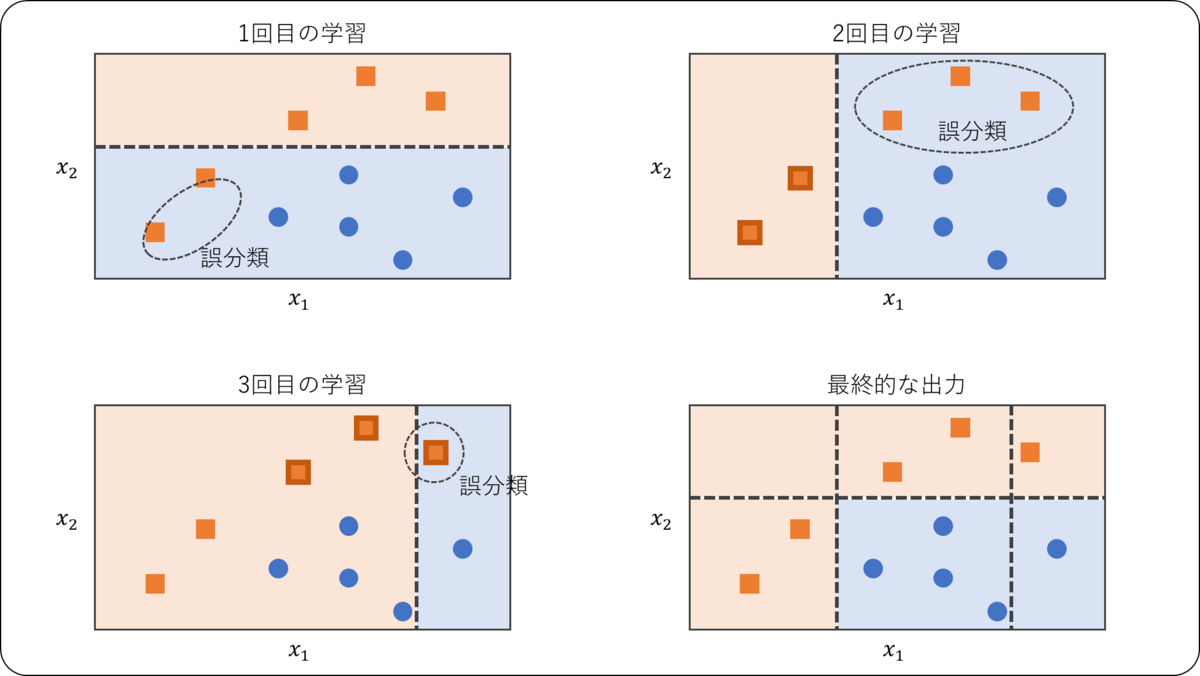
バギングでは,多数の弱分類器を学習させて,それらの多数決を最終的な出力とする。バギングでは弱分類器を独立に学習させるが,ブースティングでは1つずつ順番に学習させる。
すなわち,番目に学習させる弱分類器は,その前の
番目の弱分類器の学習結果を取り込む。
AdaBoost
AdaBoost(Adaptive Boosting)はブースティングアルゴリズムの1種で,番目の弱分類器にてご分類されたサンプルについて,
番目の弱分類器の学習の際に重みを付けることで,
番目の弱分類器ではできるだけ正しく学習させるようにする。
AdaBoostのうち,2値分類向けのAdaBoost向けのアルゴリズムとして基本的なAdaBoost.M1のアルゴリズムは以下の通りである。学習に用いるラベル付きデータは,とする。
- Step 1. 重みを初期化する。
ステップ目の
番目のサンプルの重みの初期値を,
で初期化する。
- Step 2. 以下のStep 3.~Step 7.を,
回繰り返す。
- Step 3. 弱分類器
を学習する。
以下の重み付き誤差分類数を最小化するように,
ステップ目の弱分類器
を学習する。
- Step 4. 出力を計算する。
学習結果を用いて,を計算する。
- Step 5. 誤分類数を計算する。
誤分類数を
- Step 6. ~Step 7. 重みを更新する。
以下の式により,重みを更新する。
このようにして弱分類器を計算したら,最終的な出力は
の多数決によって決める。
5.16 サンプリング手法とアンサンブル学習の組合せ
サンプリング手法とアンサンブル学習のハイブリッド手法として,RUSBoostが挙げられる。
RUSBoostでは,ブースティングの繰り返し学習の際に,多数クラスのサンプルをアンダーサンプリングで間引いて不均衡度を改善させてから弱分類器を学習させる。
5.17 不均衡データにおける性能評価
不均衡データでは,2クラス分類で用いた指標である感度や特異度が極端な値となり,評価指標としては適切ではなくなる。そのため不均衡データ解析では,感度と特異度の幾何平均であるG-meanを用いて分類モデルの性能を評価することがある。
まとめと感想
今回は,「第5章 分類問題と不均衡データ問題」における,アンサンブル学習についてまとめた。
製造業の現場データは,しばしば「不良品の発生確率が非常に低い」といった極端に不均衡なクラス構造を持つことがある。そのため,単純に精度(Accuracy)を追うだけではモデルの性能を見誤りやすく,G-meanのようなバランスを考慮した指標を使う必要があるという指摘は非常に実務的だと感じた。
また,アンサンブル学習は「ブラックボックスになりやすい」という弱点を指摘されることもあるが,ランダムフォレストの変数重要度のように,解釈可能性を担保できる仕組みが用意されているのは製造業データ解析にとって大きなメリットで,現場の技術者に説明責任を果たす際にも有効に働くと言える。
個人的には,RUSBoostのような「サンプリング+アンサンブル」のアプローチは,不良品が発生した生産工程の原因分析に直結しやすいと考えている。製造現場のデータサイエンティストとしては,今後は単一のモデル精度を追うだけでなく,データ特性に応じたアンサンブル戦略を柔軟に組み合わせる力が求められると感じた。
本記事を最後まで読んでくださり,どうもありがとうございました。

