jiku log

データサイエンスの核心を掴む : 学びと発見の記録

「確率的機械学習 入門編II」を読む ~第18章 木,森,バギング,ブースティング ④ブースティング・その2~

「確率的機械学習 入門編II」読書メモ一覧 - jiku log

はじめに

持橋大地・鈴木大慈 監訳「確率的機械学習 入門編II」は,世界的に評価の高いK.P.Murphy著 "Probabilistic Machine Learning (Book1)" の和訳であり,確率モデルに基づく機械学習,深層学習といった基礎が丁寧に整理されている。

本記事は,「第18章 木,森,バギング,ブースティング」における,ブースティングに関する読書メモである。

18.5 ブースティング

18.5.5 勾配ブースティング

前項で学んだアダブーストは,二値分類向けの手法であった。
個別の損失について,それぞれブースティングのアルゴリズムを導出するかわりに,様々な損失に適用できる一般的なアルゴリズムを導出できる。
これは,勾配ブースティング(gradient boosting)として知られる。


勾配ブースティングは,関数空間内における損失の最小化問題,すなわち


 \begin{align}
\hat{\mathbfit{f}} = \operatorname*{argmin}_{\mathbfit{f}} \mathcal{L}(\mathbfit{f}) \\ \\
\end{align}
という問題を解くことを考える。ここで関数は連続的に変化するため,無限次元になる。
そのため,関数の訓練データ集合上の値 \mathbfit{f} = (f(\mathbfit{x}_1), ..., f(\mathbfit{x}_N)) \in \mathbb{R}^Nを用いてその関数を表現する。


 m段目における \mathcal{L}(\mathbfit{f})の勾配を \mathbfit{g}_m \in \mathbb{R}^Nとすると,


 \begin{align}
g_{im} = \left[ \frac{ \partial l(y_i, f(\mathbfit{x}_i)) }{ \partial f(\mathbfit{x}_i) }    \right]_{f = f_{m-1}} \\ \\
\end{align}
である。

そして,関数の更新は,以下で与えられる。


 \begin{align}
\mathbfit{f}_m = \mathbfit{f}_{m-1} - \beta_m \mathbfit{g}_m \\ \\
\end{align}

たとえば二乗損失 \frac{1}{2} (y_i - f(\mathbfit{x}_i))^2の場合,損失関数の勾配の負値は y_i - f(\mathbfit{x}_i)になる。


これは,関数 fに対して,固定した N個の学習データでのみ最適化をしているため,汎化できない。
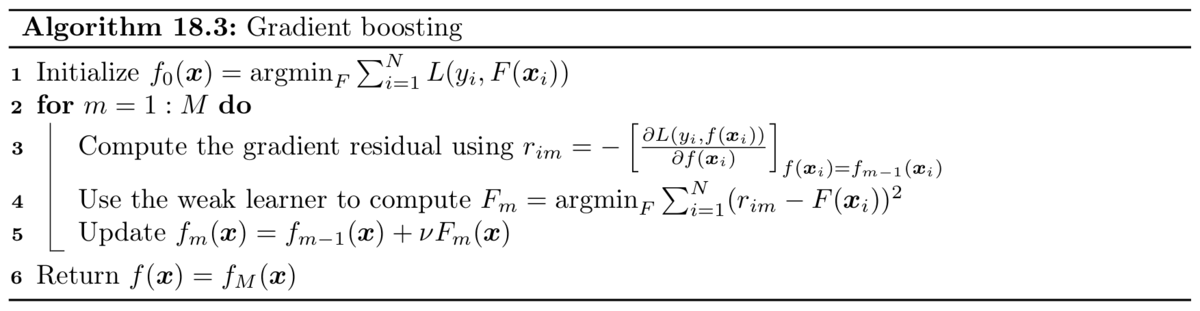
そのため,勾配にマイナスをかけた値に弱学習器をフィットさせるようにアルゴリズムを修正する。


 \begin{align}
F_m = \operatorname*{argmin}_{F} \sum_{i=1}^N (-g_{im} - F(\mathbfit{x}_m)) \\ \\
\end{align}

アルゴリズム全体は,下のようになる。ただし \nuは学習率である。


データセットが巨大な場合,各繰り返しにおいて回帰木に適用する際に,データ集合全体のうち一部のデータを用いる。この手法を確率的勾配ブースティングと呼ぶ。
この手法は,高速であるだけでなく,サブサンプリングによってある種の正則化が働くため,汎化性能が向上する。

勾配木ブースティング

実用上は,勾配ブースティングは多くの場合,以下のような回帰木を弱学習器と仮定する。


 \begin{align}
F_m(\mathbfit{x}) = \sum_{j=1}^{J_m} w_{jm}\mathbb{I}(\mathbfit{x} \in R_{jm}) \\ \\
\end{align}
ここで w_{jm}は領域 R_{jm}に対応する予測値である。

このアルゴリズムは,勾配ブースト回帰木(gradient boosted regression tree)もしくは勾配木ブースティング(gradient tree boosting)と呼ばれる。

勾配木ブースティングでは,残差に対して標準的な回帰木の学習を行なう。その後,それぞれの葉節点における重みを以下のように計算する。


 \begin{align}
\hat{w_{jm}} = \operatorname*{argmin}_{w} \sum_{\mathbfit{x}_i \in R_{jm}} l(y_i, f_{m-1}(\mathbfit{x}_i) + w) \\ \\
\end{align}

XGBoost

XGBoost(extreme gradient boosting)は,非常に効率的で広く用いられている勾配木ブースティングの実装である。
github.com


XGBoostでは,次の正則化項を加えた目的関数を最適化する。


 \begin{align}
\mathcal{L}(f) &= \sum_{i=1}^N l(y_i, f(\mathbfit{x}_i)) + \Omega(f) \\ \\
\Omega(f) &= \gamma J + \frac{1}{2} \lambda \sum_{j=1}^J w_j^2 \\ \\
\end{align}
ここで, Jは葉の数である。

 mステップ目において損失関数は以下の通りになる。


 \begin{align}
\mathcal{L}_m(F_m) = \sum_{i=1}^N l(y_i, f_{m-1}(\mathbfit{x}_i) + F_m(\mathbfit{x}_i)) + \Omega(F_m) + \mathrm{Const.} \\ \\
\end{align}

この損失関数について2次のテイラー展開は以下の通りになる。ただし h_{im}はヘシアンである。


 \begin{align}
\mathcal{L}_m(F_m) &\approx \sum_{i=1}^N \left[ l(y_i, f_{m-1}(\mathbfit{x}_i) + g_{im} F_m(\mathbfit{x}_i) + \frac{1}{2} h_{im} F_m^2(\mathbfit{x}_i)   \right]+ \Omega(F_m) + \mathrm{Const.} \\ \\
h_{im} &= \left[ \frac{ \partial^2 l(y_i, f(\mathbfit{x}_i)) }{ \partial f(\mathbfit{x}_i)^2 }   \right]_{f = f_{m-1}} \\ \\
\end{align}

●ブログ筆者註 :

通常のヘシアンは,


 \begin{align}
H_{ij} = \frac{ \partial^2 l }{ \partial x_i  \partial x_j }  \\ \\
\end{align}
のように,2種類の変数によって微分される。

しかしXGBoostのヘシアン h_{im}は,2回微分であるにもかかわらず変数が1種類しか出てこない。

これは,XGBoostの損失関数が iごとの総和になっており,ヘシアンの非対角成分が0になるためである。


回帰木の場合,弱学習器は「入力 \mathbfit{x}が所属する領域 q(\mathbfit{x})における重み w_{q(\mathbfit{x})}」となる。よって,


 \begin{align}
\mathcal{L}_m(q, \mathbfit{w}) &\approx \sum_{i=1}^N \left[ l(y_i, f_{m-1}(\mathbfit{x}_i) + g_{im} F_m(\mathbfit{x}_i) + \frac{1}{2} h_{im} F_m^2(\mathbfit{x}_i)   \right] + \gamma J + \frac{1}{2} \lambda \sum_{j=1}^J w_j^2 \\ \\

&= \sum_{j=1}^J \left[ \left( \sum_{i \in I_j} g_{im} \right)w_j + \frac{1}{2} \left( \sum_{i \in I_j} hi + \lambda \right) w_j^2 \right] + \gamma J \\ \\

&\equiv \sum_{j=1}^J \left[ G_{jm} w_j + \frac{1}{2} (H_{jm} + \lambda) w_j^2 \right] + \gamma J \\ \\
\end{align}
となる。ただし, I_jは, j番目の葉節点に割り当てられたデータ点の添え字の集合である。
また G_{jm} = \sum_{i \in I_j} g_{im}, H_{jm} = \sum_{i \in I_j} h_{im}である。


これは, w_jに関する二次形式であるので,最適な重みと損失は,それぞれ以下のようになる。


 \begin{align}
w_j^* &= - \frac{G_{jm}}{H_{jm} + \lambda} \\\\
\mathcal{L}_m(q, \mathbfit{w}^*) &= -\frac{1}{2} \sum_{j=1}^J \frac{G_{jm}^2}{H_{jm} + \lambda}  + \gamma J \\ \\
\end{align}


この目的関数を最適化するには,再帰的に節点を分割することによって行なう。
具体的には,葉節点 jを I_Lと I_Rの左右に分割するとき,この分割による利得(gain,損失関数の減少の度合い)は,


 \begin{align}
\mathrm{gain} &= \frac{1}{2} \left[ \frac{G_L^2}{H_L + \lambda} + \frac{G_R^2}{H_R + \lambda} - \frac{ (G_L + G_R)^2 }{ (H_L + H_R) + \lambda} \right] - \gamma \\ \\
G_L &= \sum_{i \in I_L} g_{im}, \quad G_R = \sum_{i \in I_R} g_{im}, \quad H_L = \sum_{i \in I_L} h_{im}, \quad H_R = \sum_{i \in I_R} h_{im} \\ \\
\end{align}
となる。ゲインが負であるならば,分割する必要がない。

18.6 木のアンサンブルの解釈

18.6.1 特徴量重要度

木のアンサンブルにおける特徴量の重要度を考える。

1つの決定木 Tについて,特徴量 kに関する特徴量重要度(feature importance)は,


 \begin{align}
R_k(T) = \sum_{j=1}^{J-1} G_j \mathbb{I}(v_j = k) \\ \\
\end{align}
となる。ただし G_jは節点 jにおける正解率に関する利得である。また, v_jは節点 jが特徴量 kを使っている場合 v_j = kとなる変数である。

アンサンブルにおける特徴量重要度は,すべての木について平均を取ることによって求められる。


 \begin{align}
R_k = \frac{1}{M} \sum_{m=1}^{M} R_k(T_m) \\ \\
\end{align}

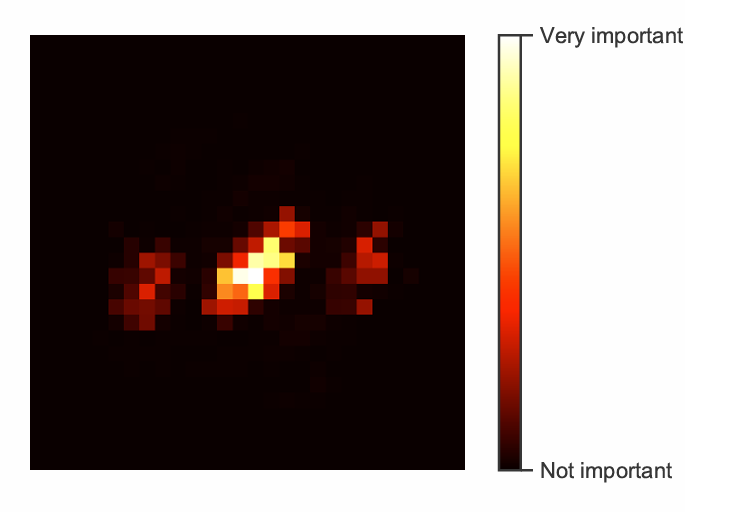
MNISTの0と8をランダムフォレストによって分類する際の特徴量重要度を下図に表す。
「0」と「8」は,数字中央部分が異なっているので,その部分の特徴量重要度が大きくなっていることが分かる。
MNISTの0と8をランダムフォレストによって分類する際の特徴量重要度

まとめと感想

今回は,「第18章 木,森,バギング,ブースティング」における,ブースティングについてまとめた。


分類問題において,非常によく用いられている手法である勾配ブースティングやXGBoostについて理解することができた。

勾配ブースティングは,「関数を用いて微分する」という,あまり見かけない演算をしているが,関数 fをあたかも変数のように扱えば,関数による勾配を考えられるという点はなかなか興味深かった。

XGBoostは,「目的関数に正則化項を加えて,ヘシアンを使って最適化する」という標準的な最適化を行なっているが,ヘシアンが対角行列になるというのが特徴的だった。
ヘシアンが対角行列になるため,最適な重みの導出が非常にシンプルになる。このような,計算が容易になるという性質が,XGBoostが有用である1つの理由だと思った。


本記事を最後まで読んでくださり,どうもありがとうございました。