
はじめに
ベイズ統計学の基礎をあらためて学ぶために,ピーター・D・ホフ 著,入江 薫・菅澤 翔之助・橋本 真太郎 訳 「標準 ベイズ統計学」を読むことにした。
本記事では,第11.1節を題材とした,NumPyroによる階層回帰モデルの分析についてまとめた。
本記事のハイライト
第11章・11.1節 階層回帰モデル
問題設定
本節では,8.4節の数学試験データをもとに,階層回帰モデルを扱う。
第8.4節では,学校ごとの数学試験データの統計モデルを構築した。
本節では,これを回帰モデルに拡張し,
- 目的変数:点数
- 説明変数:社会経済的地位(SES)
とする回帰モデルを構築する。
データの可視化
このデータは,100校分の数学試験データである。以下に,
- 左:学校ごとのSESと数学のスコアの回帰直線
- 中:学校ごとのサンプルサイズと切片
- 右:学校ごとのサンプルサイズと傾き
を可視化した。
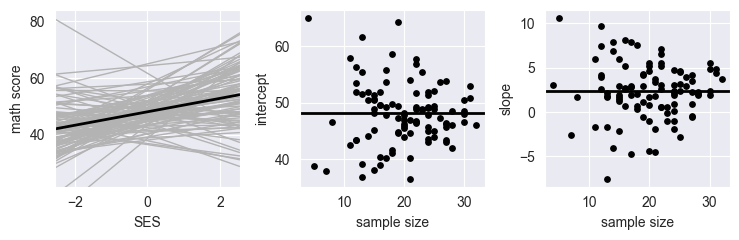
この図から,サンプルサイズが小さいと,切片も傾きもばらつきが大きくなることが確認できた。この傾向は,第8.4節と同じである。
階層回帰モデル
第8.4節の階層モデルを拡張し,階層正規モデルを考える。
集団内のモデルは,次のように記述できる。
これらをまとめると,
次に回帰係数は,グループ間の異質性を表現するために,
ここまでを図示すると,以下のようなグラフ構造として表現される。
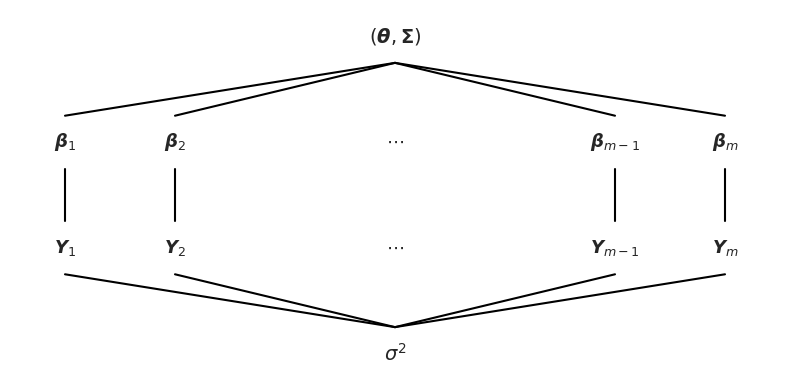
なお回帰係数は,
事前分布は以下のように設定する。
実装例
NumPyroによる実装
本記事ではNumPyroのNUTSを用いて事後分布からのサンプリングを行なった。
参考にしたコード
本記事では,Index of /~pdh10/FCBS/ReplicationのChapter11.Rを参考に作成した。
実行環境
今回は手元のPC(メモリ:16GB,コア数:10)で行なった。Pythonは,Python3.12.6を用いた。使用したライブラリ群は以下の通りである
arviz     : 0.22.0
jax       : 0.10.1
matplotlib: 3.10.9
numpy     : 2.4.6
numpyro   : 0.21.0
pandas    : 3.0.3
rdata     : 1.0.0
scipy     : 1.17.1
seaborn   : 0.13.2
sklearn   : 1.8.0
Step. 1 ライブラリを読み込む。
MCMC用など各種ライブラリを読み込んだ。
# -------------------------------
# パッケージの読み込み
# -------------------------------
# データ処理一般用
import pandas as pd
import numpy as np
import rdata

# NumPyroによるMCMC実行・可視化用
from jax import random
import jax.numpy as jnp
import numpyro
import numpyro.distributions as dist
from numpyro.infer import MCMC, NUTS
import arviz as az

# 可視化用
import matplotlib.pyplot as plt
import seaborn as sns
sns.set_style(style='darkgrid')

# 計算環境の設定
numpyro.set_platform('cpu') # CPUで動作させる。
numpyro.set_host_device_count(4) # 4チェーン並列実行のため、デバイス数を設定
Step2. データを読み込む。
データを読み込んだ。
コード:
# -------------------------------
# データの読み込み
# -------------------------------
file_path = "../r_codes/nelsSES.RData"
parsed = rdata.parser.parse_file(file_path)
converted = rdata.conversion.convert(parsed)

nels = converted["nels"]

print(nels.head(3))
print(nels.describe())
出力:
   sch_id  sch_freelunch   stu_ses  stu_mathscore
1  1011.0            6.0 -0.059948          52.11
2  1011.0            6.0  1.051652          57.65
3  1011.0            6.0 -0.863515          66.44
            sch_id  sch_freelunch       stu_ses  stu_mathscore
count  1993.000000    1993.000000  1.993000e+03    1993.000000
mean   2728.623181       5.183643  3.565192e-18      48.074456
std     764.665637       1.999848  1.000000e+00      10.239319
min    1011.000000       1.000000 -2.551005e+00      21.730000
25%    2391.000000       4.000000 -7.563727e-01      40.790000
50%    2832.000000       5.000000 -4.655553e-02      47.800000
75%    3391.000000       7.000000  7.168328e-01      55.060000
max 3702.000000 8.000000 2.538251e+00 84.000000sch_idは学校のIDなので,整数に変換する必要がある。
またstu_sesが説明変数,stu_mathscoreが目的変数である。
Step 3. データを整形する。
学校ごとに目的変数・説明変数をグルーピングした。
# -------------------------------
# データの整形
# -------------------------------
nels["sch_id"] = nels["sch_id"].astype(int)

ids = np.sort(nels["sch_id"].unique())

m = len(ids)

Y = []
X = []
N = []

for sid in ids:
    tmp = nels[nels["sch_id"] == sid]

    yj = tmp.iloc[:, 3].to_numpy()

    xj = tmp.iloc[:, 2].to_numpy()
    xj = xj - xj.mean()

    Xj = np.column_stack([
        np.ones(len(xj)),
        xj
    ])

    Y.append(yj)
    X.append(Xj)
    N.append(len(xj))

N = np.asarray(N)

p = 2
その後,学校ごとに最小二乗法を適用し,回帰直線を作成した。
# 各学校ごとのOLS
from sklearn.linear_model import LinearRegression

BETA_LS = []
S2_LS = []

for j in range(m):

    model = LinearRegression(
        fit_intercept=False
    )

    model.fit(X[j], Y[j])

    beta = model.coef_

    resid = Y[j] - X[j] @ beta

    sigma2 = np.mean(resid**2)

    BETA_LS.append(beta)
    S2_LS.append(sigma2)

BETA_LS = np.asarray(BETA_LS)
S2_LS = np.asarray(S2_LS)
Step 4. NumPyroでモデルを定義する。
事前分布および尤度をNumPyroでモデル化した。
# -------------------------------
# モデル定義
# -------------------------------
# 初期値
mu0 = BETA_LS.mean(axis=0)
L0 = np.cov(BETA_LS.T)
eta0 = p + 2
S0 = L0.copy()
nu0 = 1
s20 = S2_LS.mean()

# モデル
def hierarchical_regression(
    Y,
    X,
    mu0,
    L0,
    eta0,
    S0,
    nu0,
    s20
):

    m = len(Y)
    p = X[0].shape[1]

    # theta
    theta = numpyro.sample(
        "theta",
        dist.MultivariateNormal(
            loc=jnp.asarray(mu0),
            covariance_matrix=jnp.asarray(L0)
        )
    )

    # Sigma
    Sigma = numpyro.sample(
        "Sigma",
        dist.InverseWishart(
            concentration=eta0,
            scale_matrix=jnp.asarray(S0)
        )
    )

    # sigma^2
    sigma2 = numpyro.sample(
        "sigma2",
        dist.InverseGamma(
            concentration=nu0 / 2,
            rate=nu0 * s20 / 2
        )
    )

    # school-level coefficients
    with numpyro.plate("school", m):

        beta = numpyro.sample(
            "beta",
            dist.MultivariateNormal(
                loc=theta,
                covariance_matrix=Sigma
            )
        )

    # likelihood
    for j in range(m):

        mean_j = jnp.dot(
            jnp.asarray(X[j]),
            beta[j]
        )

        numpyro.sample(
            f"y_{j}",
            dist.Normal(
                mean_j,
                jnp.sqrt(sigma2)
            ),
            obs=jnp.asarray(Y[j])
        )
Step 5. MCMCを実行する。
MCMCによって,パラメータの事後分布からサンプリングを実行した。
# -------------------------------
# MCMC実行
# -------------------------------
rng_key = random.PRNGKey(1)
nuts_kernel = NUTS(hierarchical_regression)

mcmc = MCMC(
    nuts_kernel,
    num_warmup=2000,
    num_samples=10000,
    num_chains=4,
    progress_bar=True,
)

mcmc.run(
    rng_key,
    Y=Y,
    X=X,
    mu0=mu0,
    L0=L0,
    eta0=eta0,
    S0=S0,
    nu0=nu0,
    s20=s20
)
Step 6. 収束判定を行なう。
Rhatなどにもとづき,収束判定を行なった。
コード:
# -------------------------------
# 収束判定
# -------------------------------
print("\nMCMCサマリー:")
mcmc.print_summary(prob=0.95)

# -------------------------------
# 可視化
# -------------------------------
# ArviZへ変換
idata = az.from_numpyro(mcmc)

# トレースプロット
az.plot_trace(
    idata,
    var_names=[
        "Sigma",
        "sigma2",
        "theta",
    ],
    compact=True
)
plt.tight_layout()
plt.show()
出力:
MCMCサマリー:

                mean       std    median      2.5%     97.5%     n_eff     r_hat
Sigma[0,0]     23.57      4.13     23.18     15.92     31.74  44686.86      1.00
Sigma[0,1]      1.34      1.63      1.31     -1.83      4.60  13989.10      1.00
Sigma[1,0]      1.34      1.63      1.31     -1.83      4.60  13989.10      1.00
Sigma[1,1]      2.78      1.03      2.65      1.03      4.85   5576.03      1.00
 beta[0,0]     50.59      1.51     50.60     47.60     53.51  84692.57      1.00
 beta[0,1]      3.57      1.20      3.55      1.21      5.91  52027.07      1.00
 beta[1,0]     46.81      1.75     46.81     43.32     50.22  86279.30      1.00
 beta[1,1]      4.02      1.34      3.97      1.38      6.63  34505.54      1.00
...
beta[99,0]     48.01      1.51     48.01     45.02     50.94  85421.44      1.00
beta[99,1]      2.37      1.12      2.36      0.13      4.55  76587.74      1.00
    sigma2     77.85      2.61     77.79     72.84     83.03  57836.55      1.00
  theta[0]     48.11      0.53     48.11     47.05     49.13  62549.79      1.00
  theta[1]      2.38      0.29      2.38      1.83      2.96  22002.16      1.00

Number of divergences: 0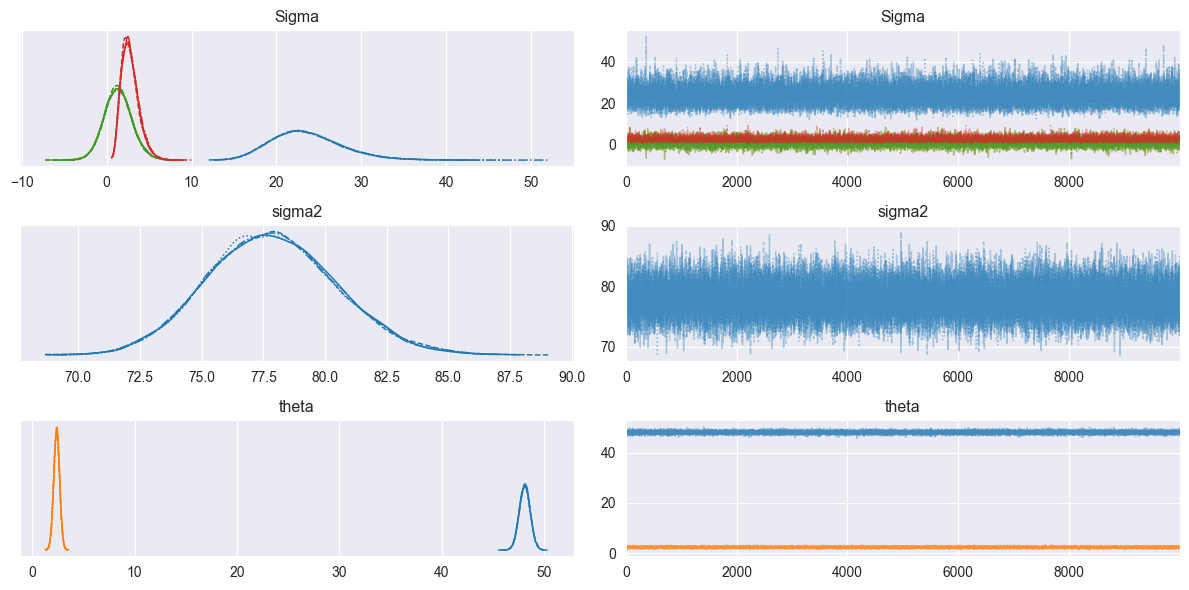
Rhatとトレースプロットから,収束は問題なさそうであった。
事後分析
グループ間の回帰係数
グループ間の回帰係数は,theta[1]である。この95%信用区間はであり,学校ごとの回帰係数は,正の傾きを持つという傾向が確認できた。
階層正規モデルによる縮小効果
階層正規モデルを用いると,サンプル数が少ない学校の回帰係数が,全体の効果の影響を受けやすくなる(縮小効果)。
学校ごとに最小二乗法を適用した結果と,階層正規モデルを用いた結果を下図に示した。
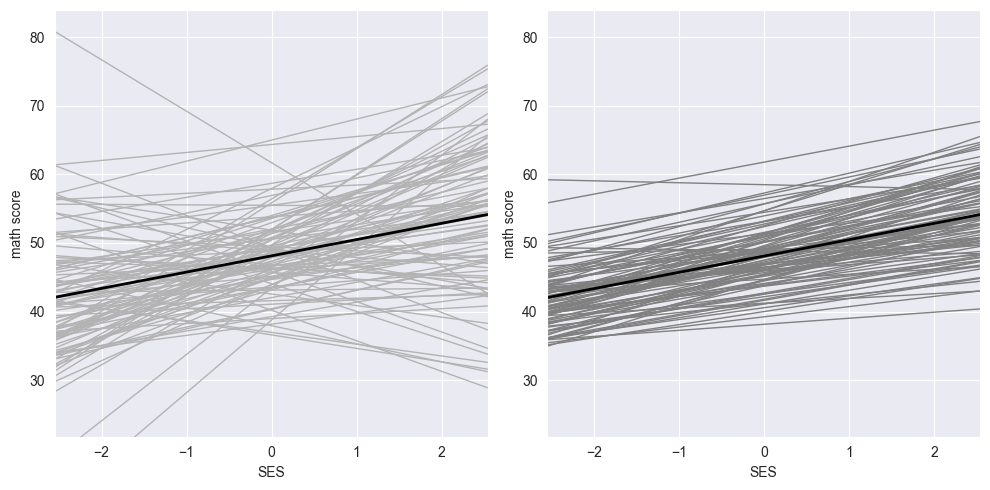
この図から,単に学校ごとに最小二乗法を適用した場合に比べると,階層正規モデルを適用したほうが,回帰直線の傾向が似てくる(ばらつきが減る)ということが確認できた。
描画用コード:
まとめと感想
本記事では,第11.1節を題材とした,NumPyroによる階層回帰モデルの分析についてまとめた。
階層モデルによる縮小効果は第8.4節で学んだが,今回はこれを回帰モデルに適用した。その結果,回帰係数において縮小効果を確認することができた。
学校のデータに限らず,このような固定効果・ランダム効果からなるモデルは実務でもよく出てくるので,今後はこのようなモデルも適用していきたい。
本記事を最後まで読んでくださり,どうもありがとうございました。

