jiku log

データサイエンスの核心を掴む : 学びと発見の記録

【統計検定準1級対策】独立と無相関 ~「機械学習のための確率と統計」で学ぶ

はじめに

講談社の「機械学習プロフェッショナルシリーズ」の「機械学習のための確率と統計」は,AI・機械学習の基礎理解に役立つ本であるが,統計検定1級や統計検定準1級の学習を進めるうえでも参考になると感じている。


本記事では,「第4章 多次元確率分布の性質」を題材に,独立と無相関についてまとめた。

想定読者

統計検定準1級・1級に興味を持たれている方で,基礎理解の勉強を一通りされており,各単元の内容の理解を深めようとしている方。

第4章 多次元確率分布の性質

独立と無相関

本章の4.6節では,独立と無相関の違いについて説明している。


確率変数 x, yについて,


 \begin{align}
f(x, y) = g(x) h(y) \\ \\
\end{align}
が成り立つとき, xと yは統計的に独立(independent)であるという。


 xと yが独立であるとき, xと yは無相関になる。すなわち,

  •  xと yが独立である \Leftarrow  \mathrm{Cov}[x, y] = 0

が成り立つ。


一方で,この逆はかならずしも成り立たない。すなわち,独立性も無相関性も,ともに xと yの「無関係さ」を表すが,独立性の方が無相関性よりも強い。


たとえば,


 \begin{align}
f(x, y) 
  \begin{cases}
    1 & (\lvert x \rvert + \lvert y \rvert \leq 1/\sqrt{2}) \\ \\
    0 & (\text{otherwise})
  \end{cases}
\\ \\
\end{align}
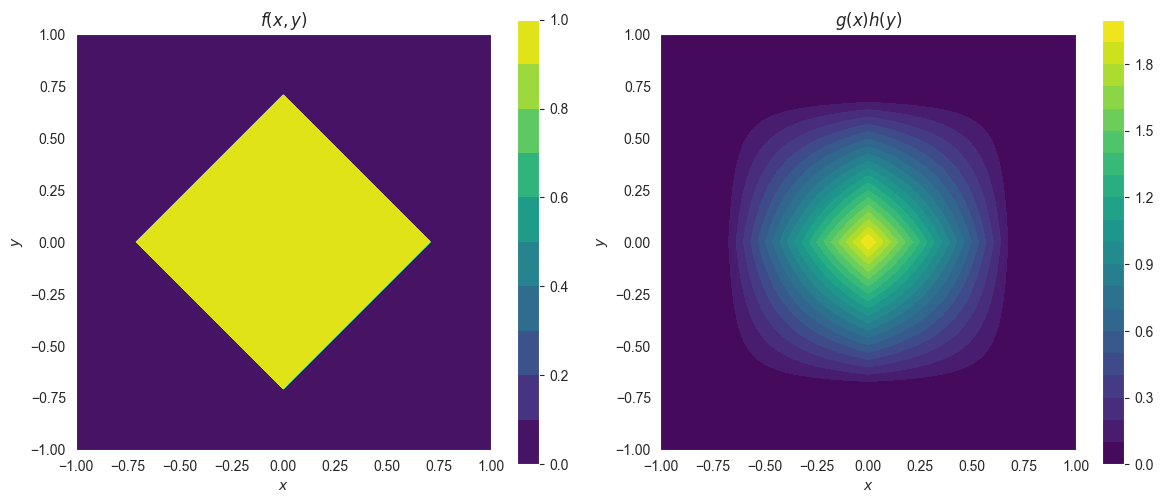
を考えると, xと yは無相関ではあるが,独立ではない。


 \mathrm{Cov}[x, y]を計算すると,これは0になる。
一方で xと yの周辺確率密度関数は,


 \begin{align}
g(x) &= \max(0, \sqrt{2} - 2 \lvert x \rvert ), \\ \\
h(y) &= \max(0, \sqrt{2} - 2 \lvert y \rvert ) \\ \\
\end{align}
なので,

 \begin{align}
f(x, y) \neq g(x) h(y) \\ \\
\end{align}
となり, xと yは独立ではない。

無相関だが独立でない確率変数xとyの例

2変量正規分布

一般に,「無相関」⇒「独立」は成立たないが,2変量正規分布の場合は,これが成り立つ。


2変量正規分布は以下の式で表される。


 \begin{align}
\mathcal{N} (\mathbfit{\mu}, \mathbfit{\Sigma}) = 
\frac{1}{(2\pi)^{1/2}  \lvert \mathbfit{\Sigma} \rvert ^{1/2}}
\exp \left(
 -\frac{1}{2} (\mathbfit{z} - \mathbfit{\mu})^T \mathbfit{\Sigma} (\mathbfit{z} - \mathbfit{\mu})
\right) \\ \\
\end{align}
ただし, \mathbfit{z} = [x, y]^Tである。


 \expの部分を詳細に書くと,


 \begin{align}
\mathcal{N}
\left(
\begin{bmatrix}
  \mu_x \\
  \mu_y \\
\end{bmatrix}
,
\begin{bmatrix}
  \sigma{xx} & \sigma_{xy} \\
  \sigma_{yx} & \sigma_{yy} \\
\end{bmatrix}

\right) 

\propto

\exp
\left(
 -\frac{1}{2}
\begin{bmatrix}
   (x - \mu_x)^T & (y - \mu_y)^T \\
\end{bmatrix} 

\begin{bmatrix}
  \sigma^2_{xx} & \sigma_{xy} \\
  \sigma_{yx} & \sigma^2_{yy} \\
\end{bmatrix}^{-1}

\begin{bmatrix}
  x - \mu_x \\
  y - \mu_y \\
\end{bmatrix}

\right) \\ \\ 
\end{align}
となる。


 xと y無相関である場合, \sigma_{xy} = \sigma_{yx} = 0となるが,このとき


 \begin{align}
&\exp
\left(
 -\frac{1}{2}
\begin{bmatrix}
   (x - \mu_x)^T & (y - \mu_y)^T \\
\end{bmatrix} 

\begin{bmatrix}
  \sigma^2_{xx} & 0 \\
  0 & \sigma^2_{yy} \\
\end{bmatrix}^{-1}

\begin{bmatrix}
  x - \mu_x \\
  y - \mu_y \\
\end{bmatrix}

\right) \\ \\ 

=&\exp
\left(
 -\frac{1}{2}
 \frac{(x - \mu_x)^2}{\sigma_{xx}^2}
\right) 

\times 

\exp
\left(
 -\frac{1}{2}
 \frac{(y - \mu_y)^2}{\sigma_{yy}^2}
\right) \\ \\ 
\end{align}
となり, xを含む確率密度関数と, yを含む確率密度関数が分離されるので,独立になる。

感想とまとめ

本記事では,「第4章 多次元確率分布の性質」を題材に,独立と無相関についてまとめた。


2つの確率変数の関係について,無相関も独立も重要な概念であるが,独立の方が強い概念であるため,その違いには注意する必要がある。

統計検定準1級・1級の問題において2変数の関係を聞かれたときに,無相関なのか独立なのか,という違いを意識して問題を解くことが重要である。


本記事を最後まで読んでくださり,どうもありがとうございました。