
はじめに
ベイズ統計学の基礎をあらためて学ぶために,ピーター・D・ホフ 著,入江 薫・菅澤 翔之助・橋本 真太郎 訳 「標準 ベイズ統計学」を読むことにした。
本記事では,第7.5節を題材とした,ギブスサンプラーによる多変量正規分布に対する欠測データの扱いと代入法についてまとめた。
本記事のハイライト
- 多変量正規分布でモデル化することで,欠測値補完のためのギブスサンプラーが容易に構成できることを説明した。
- 欠測値の補完は,変数間の相関に基づいて行なわれており,補完がしやすい・しづらい状況を説明した。
第7章 多変量正規モデル
問題設定
今回扱うデータセットは,200人の女性の健康状態に関する測定値のデータセットである。計測項目は,以下の4項目である。
- glu : 血漿グルコース濃度
- bp : 拡張期血圧
- skin : 皮膚のひだの厚さ
- bmi : BMI
である。
興味があることは,
- 各計測項目間の相関係数
- ある計測項目を目的変数,残りの計測項目を説明変数としたときの回帰係数
など,計測項目間の関係性である。
このデータセットにおける散布図とヒストグラムは下図のようになる。
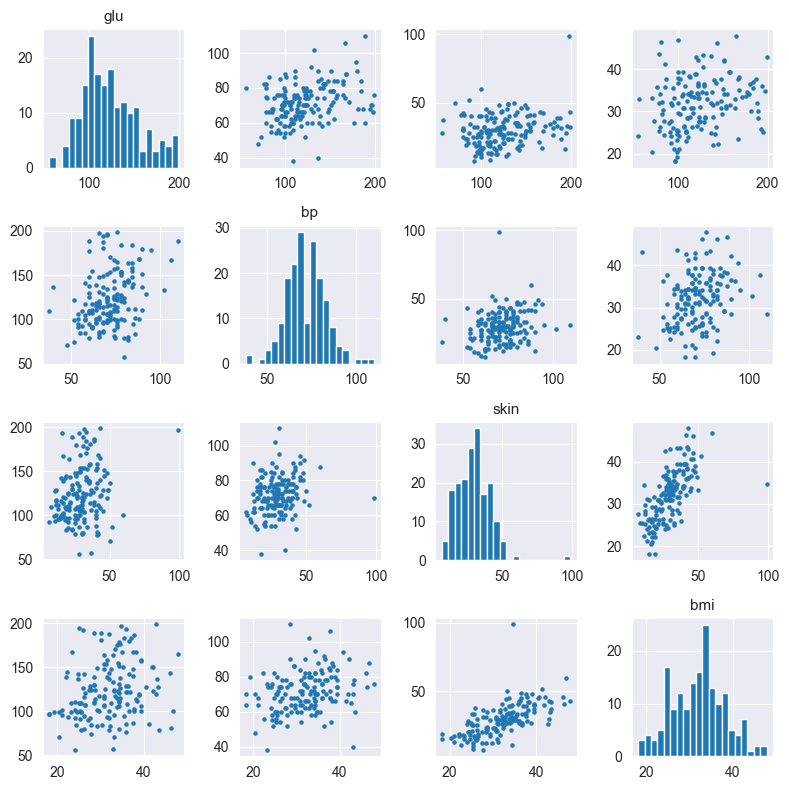
この図から,skinとbmiの間には正の相関があり,他の計測項目間には特に相関がないように見える。
データの欠測と対処法
このデータセットは,原著のサポートページ https://www2.stat.duke.edu/~pdh10/FCBS/Inline/ にある,Y.pima.missというデータである。このデータは以下のようになっている。
"glu","bp","skin","bmi"
86,68,28,30.2
195,70,33,NA
77,82,NA,35.8
NA,76,43,47.9
107,60,NA,NA
...
このデータは,欠測(NA)を含んでいる。欠測が無い行だけ選んで分析すると,データが減ってしまう。
そのため,何らかの方法で欠測を補完することで,サンプル数を減らさずに分析することを試みる。
なおサンプルコードでは,真値と予測値の比較をするために,真値に対して確率的なマスクを施すことで欠測のあるデータを生成している。
本書では,以下の手順によってデータの補完を行なっている。
- データが,多変量正規分布(変数の数は4つ)から生成されているとする。
- 欠測はランダムな欠測(missing at random)とする。
- ギブスサンプリングによって,多変量正規分布のパラメータおよび欠損値の事後分布のサンプルを得る。
多変量正規分布を仮定することで,
- 周辺確率密度関数
- ある変数で条件付けた条件付き確率密度関数
がそれぞれ正規分布になる,という性質があり,計算がしやすくなる。
また,ランダムな欠測,すなわち観測データと欠測の位置
が独立である,と仮定することで,観測データの分布と欠測の位置の分布を分けて考えることができるようにしている。
最後にギブスサンプリングは,平均,分散共分散行列
および欠測値
の事後分布のサンプリングを行なう。
手順は以下のようになる。ただしは観測されたデータである。
- ギブスサンプリング
1. の分布は,平均がしたがう確率分布なので,多変量正規分布である。
2. の分布は,分散共分散行列がしたがう確率分布なので,逆ウィシャート分布である。
3. の分布は,で条件付けられた
の分布なので,多変量正規分布の条件付き分布となる。
NumPyroによる実装例
当ブログにおける他の記事では,ギブスサンプラーを使わないNumPyroの実装例を示している。
しかし今回は,欠測値を観測できているデータで予測する,という枠組みになっており,欠測値の補完方針が明確なので,ギブスサンプラーを用いることとした。
そのため,NumPyroにおけるMCMCの標準的な機能を使えないが,必要に応じて可視化機能なども実装した。
参考にしたコード
本記事では,Index of /~pdh10/FCBS/ReplicationのChapter7.Rを参考に作成した。
実行環境
今回は手元のPC(メモリ:16GB,コア数:10)で行なった。Pythonは,Python3.12.6を用いた。使用したライブラリ群は以下の通りである
arviz     : 0.22.0
jax       : 0.10.1
matplotlib: 3.10.9
numpy     : 2.4.6
numpyro   : 0.21.0
pandas    : 3.0.3
scipy     : 1.17.1
seaborn   : 0.13.2
Step. 1 パッケージを読み込む。
MCMC用など各種パッケージを読み込んだ。なおNumPyroは,その確率密度関数を使うにとどめており,MCMCなどは使わなかった。
# -------------------------------
# パッケージの読み込み
# -------------------------------
# データ処理一般用
import pandas as pd
import numpy as np

# NumPyroによるMCMC実行・可視化用
import jax
from jax import random
import jax.numpy as jnp
import numpyro
import numpyro.distributions as dist
from numpyro.infer import MCMC, NUTS
import arviz as az

# 可視化用
import matplotlib.pyplot as plt
import seaborn as sns
sns.set_style(style='darkgrid')

# 計算環境の設定
numpyro.set_platform('cpu') # CPUで動作させる。
numpyro.set_host_device_count(4) # 4チェーン並列実行のため、デバイス数を設定
Step2. データを読み込む。
今回扱ったデータは,https://www2.stat.duke.edu/~pdh10/FCBS/Inline/Y.pima.full から入手できる。
今回は,このファイルをPythonから直接読み込むことを試みたが,変換処理が大変だったため,Rを使ってこのファイルを読込み,Y_pima_full.csvというファイル名で出力しておき,これを読み込んだ。
その後,人工的な欠測を生成した。
# -------------------------------
# データの読み込み
# -------------------------------
file_path = "../r_codes/Y_pima_full.csv"
Y0 = pd.read_csv(file_path)

colnames = Y0.columns.values

Y0 = Y0.iloc[:, 0:4].to_numpy(dtype=float)
n, p = Y0.shape
Step 3. データを整形する。
先述の通り,欠測のないデータに対して,人工的な欠測を生成し,欠測ありデータをシミュレーションした。
コード:
# 人工的な欠測生成
rng = np.random.default_rng(1)

O = rng.binomial(1, 0.9, size=(n, p))

Y = Y0.copy()
Y[O == 0] = np.nan

print(np.sum(np.isnan(Y)))
出力:
84
欠測は,200×4=800個のデータのうち,84個が欠測していることが確認できた。
Step 4. パラメータの初期値を設定する。
事前分布のパラメータを設定した。なお欠測値の推定を行なうが,初期値として平均値を代入した。
# 事前分布
mu0 = np.array([120, 64, 26, 26])

sd0 = mu0 / 2

L0 = np.full((p, p), 0.1)
np.fill_diagonal(L0, 1)

L0 *= np.outer(sd0, sd0)

nu0 = p + 2
S0 = L0

# 初期値は平均代入
Y_full = Y.copy()

for j in range(p):
    m = np.nanmean(Y_full[:, j])
    Y_full[np.isnan(Y_full[:, j]), j] = m

Sigma = S0.copy()
Step 5. ギブスサンプラーを実行する。
完全条件付き分布を記述し,ギブスサンプリングを実行した。
コード:
# -------------------------------
# Gibbs Sampler
# -------------------------------
from numpy.random import default_rng
rng = default_rng(1)

n_iter = 1000

THETA = []
SIGMA = []
YMISS = []

rng_key = jax.random.PRNGKey(1)

for s in range(n_iter):
    key, subkey = jax.random.split(rng_key)

    # theta
    ybar = Y_full.mean(axis=0)

    Ln = np.linalg.inv(
        np.linalg.inv(L0)
        + n * np.linalg.inv(Sigma)
    )

    mun = Ln @ (
        np.linalg.inv(L0) @ mu0
        + n * np.linalg.inv(Sigma) @ ybar
    )

    theta = rng.multivariate_normal(
        mean=mun,
        cov=Ln
    )

    # Sigma
    centered = Y_full - theta

    Sn = S0 + centered.T @ centered

    Sigma = np.array(
        dist.InverseWishart(
            concentration=nu0 + n,
            scale_matrix=jnp.asarray(Sn)
        ).sample(subkey)
    )

    # missing values
    for i in range(n):

        b = (O[i] == 0)
        a = (O[i] == 1)

        if not np.any(b):
            continue

        Sigma_aa = Sigma[np.ix_(a, a)]

        Sigma_ba = Sigma[np.ix_(b, a)]
        Sigma_ab = Sigma[np.ix_(a, b)]
        Sigma_bb = Sigma[np.ix_(b, b)]

        inv_aa = np.linalg.inv(Sigma_aa)

        beta = Sigma_ba @ inv_aa

        s2 = (
            Sigma_bb
            - Sigma_ba @ inv_aa @ Sigma_ab
        )

        theta_j = (
            theta[b]
            + beta @ (
                Y_full[i, a]
                - theta[a]
            )
        )

        Y_full[i, b] = rng.multivariate_normal(
            theta_j,
            s2
        )

    THETA.append(theta)
    SIGMA.append(Sigma.copy())
    YMISS.append(
        Y_full[O == 0].copy()
    )

# サンプルの保存
THETA = np.asarray(THETA)
SIGMA = np.asarray(SIGMA)
YMISS = np.asarray(YMISS)

print(THETA.shape) # (1000,p)
print(SIGMA.shape) # (1000,p,p)
print(YMISS.shape) # (1000,n_missing)
出力:
(1000, 4)
(1000, 4, 4)
(1000, 84)
平均の次元は4,分散共分散行列の大きさは4×4,欠測の次元は84であることが確認できた。
また事後分布のサンプル数は1000であった。
Step 6. 収束判定を行なう。
収束判定を行なうには,Arvizのトレースプロットを使うと分かりやすい。そのために,データ整形を行なってからArvizの各種関数を適用した。
サンプルコード:
出力:
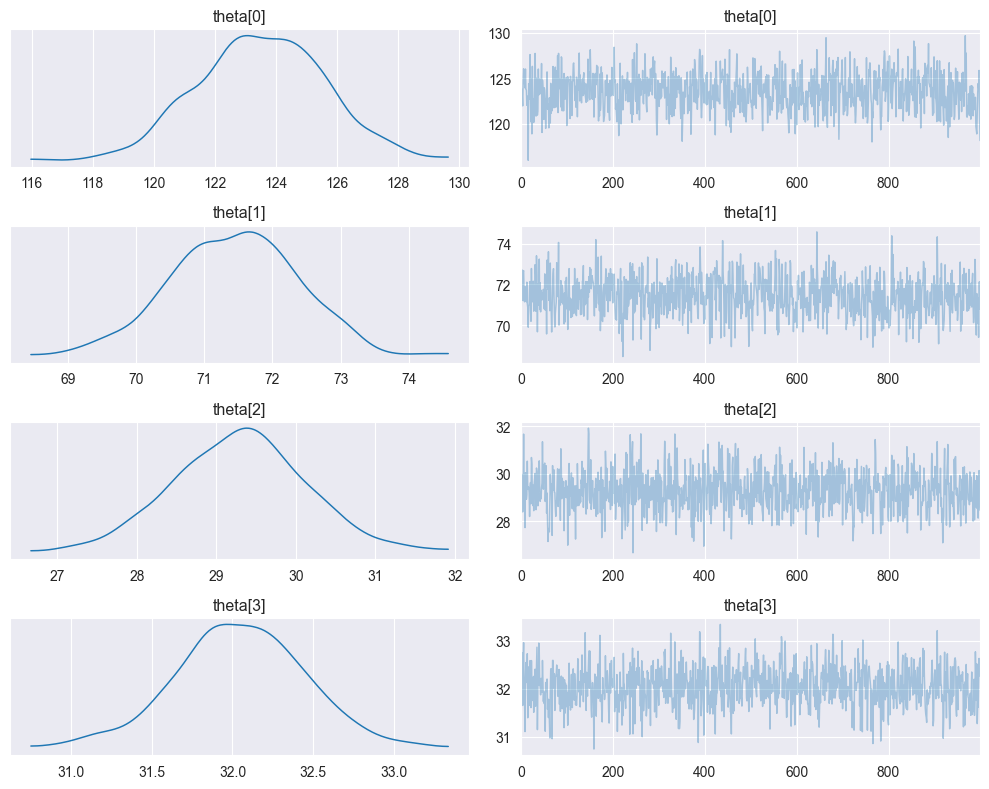
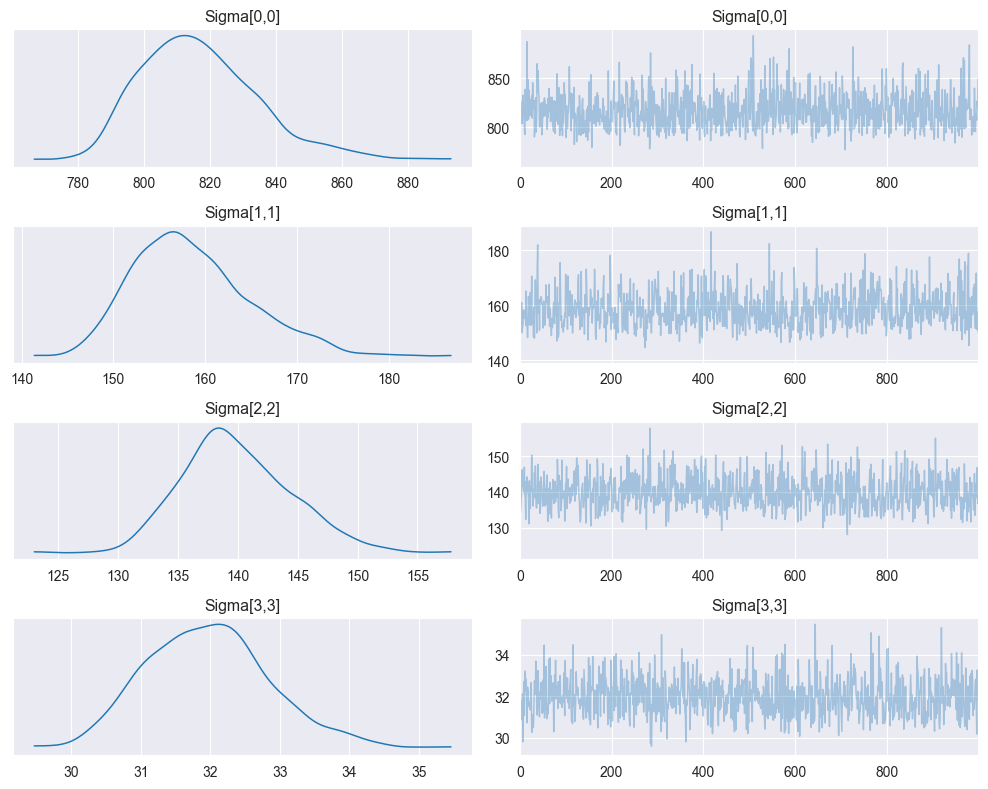
平均ベクトルおよび分散共分散行列の対角成分の事後分布は,問題なく収束しているようであった。
欠測補完後の事後分析
相関係数
今回は,4つの計測項目の関係性に興味がある。そのため,分散共分散行列から相関行列を計算する。
分散共分散行列のサンプルは1000個あるが,各サンプルから相関行列を計算し,その平均を取った。
サンプルコード:
# -------------------------------
# 結果の確認
# -------------------------------
# 事後平均
theta_mean = THETA.mean(axis=0)
print("事後平均:{}".format(theta_mean))

# 相関行列
COR = np.empty((p, p, n_iter))

for s in range(n_iter):
    Sig = SIGMA[s]
    d = np.sqrt(np.diag(Sig))
    COR[:, :, s] = (Sig / np.outer(d, d))

COR_mean = COR.mean(axis=2)
print("相関行列:\n{}".format(np.round(COR_mean, 3)))
出力:
事後平均:[123.52071803  71.43777162  29.28882127  32.04410536]
相関行列:
[[1.    0.299 0.253 0.333]
 [0.299 1.    0.344 0.333]
 [0.253 0.344 1.    0.677]
 [0.333 0.333 0.677 1.   ]]
はじめに散布図行列を確認した際には,skinとbmiの間には正の相関がありそうだった。
出力の相関行列を確認すると,当該箇所の相関係数は0.677であり,他の相関係数に比べると大きい値となっていた。
サンプル外検証
欠測のないデータ(真値)と,欠測が補完されたデータ(予測値)を比較した。
サンプルコード:
出力:
glu: 1308.2725509398551
bp: 182.5959539609108
skin: 54.77831951351077
bmi: 22.821758132078056
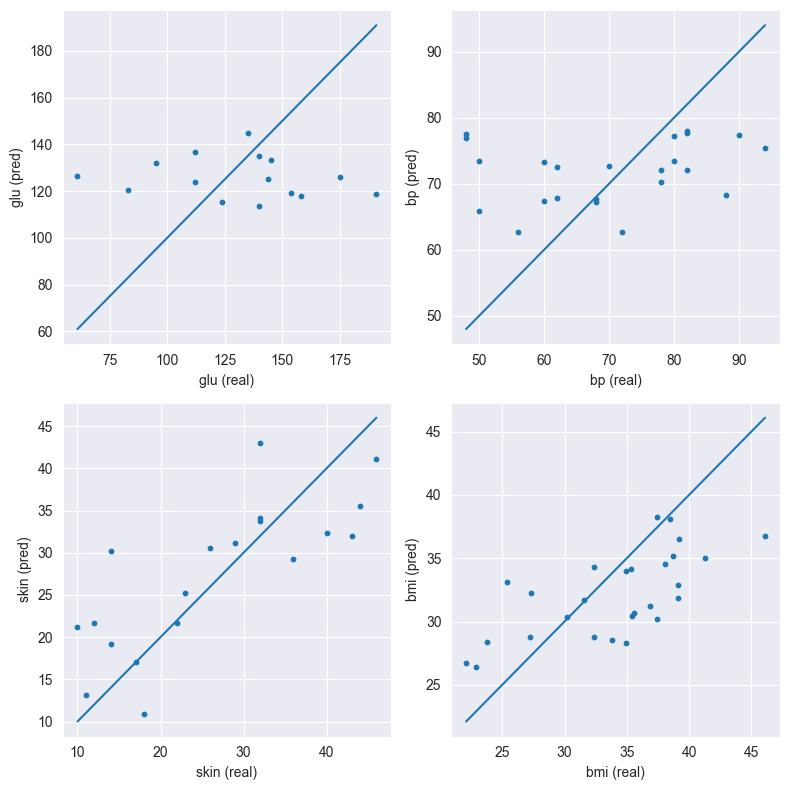
gluとbpは,他の計測項目との相関係数が大きくないため,予測はあまりうまくいっておらず,また二乗誤差も大きかった。
一方で,skinとbmiは相関が強く,それぞれを予測しあうことができるため,予測は比較的上手くいっていることが確認できた。
まとめと感想
本記事では,第7.5節を題材とした,ギブスサンプラーによる多変量正規分布に対する欠測データの扱いと代入法についてまとめた。
多変量正規分布は,欠測がある変数群と欠測が無い変数群を分離した際に,周辺確率や条件付き確率が綺麗な形で現れるため,サンプル生成もしやすかった。
また,完全条件付き分布も求められるため,ギブスサンプリングも容易であった。
データの取得方法によっては,欠測が発生してしまうことがある。今回のように欠測を補完できれば,サンプル数を十分に確保しながら分析できる可能性があることが確認できた。
しかし欠測の補完は,他の変数との相関を用いて行なっているため,他の変数との相関が小さいものは補完もしづらいことが確認できた。
実業務で補完を試みる際には,他の変数との関係性を確認しておきたい。
本記事を最後まで読んでくださり,どうもありがとうございました。

