
はじめに
藤原 幸一 著「スモールデータ解析と機械学習」は,サンプル数が少ない状況でのモデル構築や予測精度の確保,統計的な不確実性の扱い方など,現場で直面する悩みに直結する理論と実践がコンパクトにまとまっている。製造業のデータ解析において「少ないデータだから仕方ない」と諦めるのではなく,「少ないからこそできる工夫」を身につけるためにこの本を読み,その学びをブログで共有しようと思う。
本記事は,「第6章 異常検知問題」における,時系列データの取り扱いに関する読書メモである。
6.6 時系列データの取り扱い
異常検知問題は,連続的に測定される時系列データを対象にすることが多いため,時系列の特性,例えば自己相関などを特徴にすると,異常検知性能が改善することがある。
自己相関関数
自己相関関数は,時系列データ上の異なる点の間の相関として定義される。具体的には,
PCAによる自己相関の抽出
主成分分析(PCA)は,変数間の相関関係を抽出するための方法であった。PCAを自己相関を計算するには,データ行列から以下のような行列を作成する。
ハンケル行列について,
と
のどちらが大きいか,ということは本書中には明示されていないが,長さ
のベクトルをもとのデータから切り出し,特徴的な波形を取り出すことを考えると,
と考えるのが妥当であるため,
は縦長の行列であると考えられる。
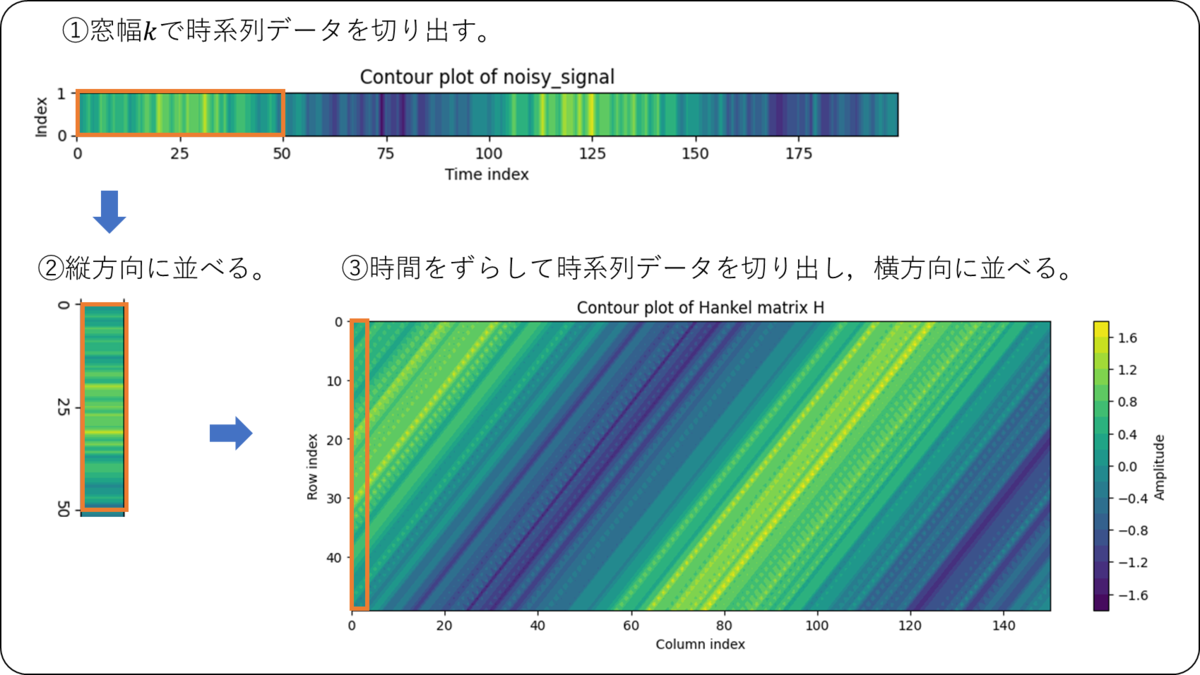
時系列データからの転置行列
を作る手順は下図の手順のようになる。
特異スペクトル分析
本節では,時系列データに対する異常診断である特異スペクトル分析(Singular Spectrum Analysis; SSA)が紹介されていた。
SSAは,異常検知と変化検知 | 書籍情報 | 株式会社 講談社サイエンティフィクにおいて詳細に説明されている。また,SSAの基本的な考え方であるハンケル行列に対する特異値分解については,当ブログの過去記事である「続々 制御工学のこころ」を読む ~第6章 ビヨンド最小二乗法 ④補足:時系列データに対する特異値分解(実践編)~ - jiku logにも説明した。よってこれらの文献を参照し,SSAについて確認した。
本書で紹介されているは縦型の行列になる。ここで,「続々 制御工学のこころ」を読む ~第6章 ビヨンド最小二乗法 ④補足:時系列データに対する特異値分解(実践編)~ - jiku logにならい,ハンケル行列を転置して
を考え,これを特異値分解することを考える。
SSAでは,左特異ベクトルからなる行列に基づき,異常診断を行なう。これは,
次元の左特異ベクトルは,窓幅
で区切った時系列データを代表する波形を表しており,この代表的な波形パターンと診断対象のデータを比較する,という考えに基づいていると言える。
まとめと感想
今回は,「第6章 異常検知問題」における時系列データの取り扱いについてまとめた。
製造業の現場では,温度・圧力・振動などのセンサーから連続的にデータが得られるため,時系列の特徴を活かした異常検知は非常に重要だと感じた。単純に瞬間値だけを監視しても,プロセス全体の異常は見逃してしまうことが多い。特に振動や電流の波形監視では,自己相関や周期性の変化こそが異常の兆候となることが多いため,本節の内容は実務に直結する。
PCAやSSAを使って時系列を分解するアプローチは,現場データの「背後にある支配的なパターン」を抽出し,正常運転の基準を構築できる点で有用だと感じた。一方で,SSAは窓幅の設定や分解後の解釈が難しいため、モデルのブラックボックス化を避ける工夫(可視化や寄与率分析など)が必要だろう。
実務では,まずはPCAによる基礎的な異常検知を行ない,その後SSAのような高度な手法を導入することで,設備ごとの周期性や特徴的な波形に即した監視が実現できるのではないかと考える。
本記事を最後まで読んでくださり,どうもありがとうございました。

