
はじめに
森下光之助 著 「ビジネス課題を解決する技術~数理モデルの力を引き出す3ステップフレームワーク」は、数理モデルを活用して課題を体系的に解決する手法を提供する。本書を読む理由は,データサイエンスを製造業の現場に効果的に適用するための実践的なフレームワークを学び,チームの分析力を強化し,事業成果を最大化するためである。本書はマーケティングを題材としているが,製造業での応用を意識しながら読み進めていく。
本記事は,「5章 離散最適化で広告出稿番組を選択する」における前半部分に関する読書メモである。
本記事を読むことで得られること
本記事を読むことで得られることは,主に以下の内容である。
- 繰り返し期待値の公式を用いた数理モデルの構築方法
5章 離散最適化で広告出稿番組を選択する
第4章では,複数媒体のリーチ重複を,補正係数を用いて調整する方法を説明していた。しかしこの方法では,媒体が個あると,推定するべき補正係数の数が
個になり,媒体数が増えると計算が大変になる。
第5章では,補正係数に頼らない新たな方法で数理モデリングを行ない,予算配分を最適化する方法を解説している。
5.1 ビジネス課題:番組選択の最適化
第4章では,CMの出稿先が2種類しかなかったが,CM出稿を検討する番組の候補は,数十から百以上にのぼることもある。本章では,「番組選択の最適化」を新たなビジネス課題として取り上げる。
5.2 ステップ1:ビジネス課題を数理最適化問題として定式化する
本節では,今回の問題設定を,数理最適化問題として定式化する。
変数の定義
今回の問題設定で現れる変数を説明する。
: 広告を出稿可能な番組の候補の数。
: 番組の番号。
: 番組
で放送されたCMに一度でも接触したら1を取る確率変数。
: 番組
: 広告予算。
決定変数
今回動かせる変数は,どの番組にCMを出稿するかという出稿の有無である。これをベクトルであらわす。また
とする。以降では,選択した番組の組合せを番組群と表現する。
目的関数
CMを出稿した番組のうち,いずれかのCMに接触したら1をとる確率変数をとする。
今回最大化したい指標は,複数番組合算のユニークリーチ(以下,単に「合算のユニークリーチ」)とする。
したがって目的関数は,選択した番組群で条件付けた合算のユニークリーチ
である。
制約条件
番組群に対するコストを予算内に収めるという制約は,
解くべき最適化問題
これらをまとめると,解くべき最適化問題は以下のようになる。
5.3 ステップ2:数理モデル構築し、未知のパラメータをデータから推定する
本節では,未知のパラメータをデータから推定するために,数理モデルを構築する方法を説明している。
対象とするデータ
今回のデータには,企業ごとに,CMを出稿した番組と獲得できたユニークリーチが記録されている。
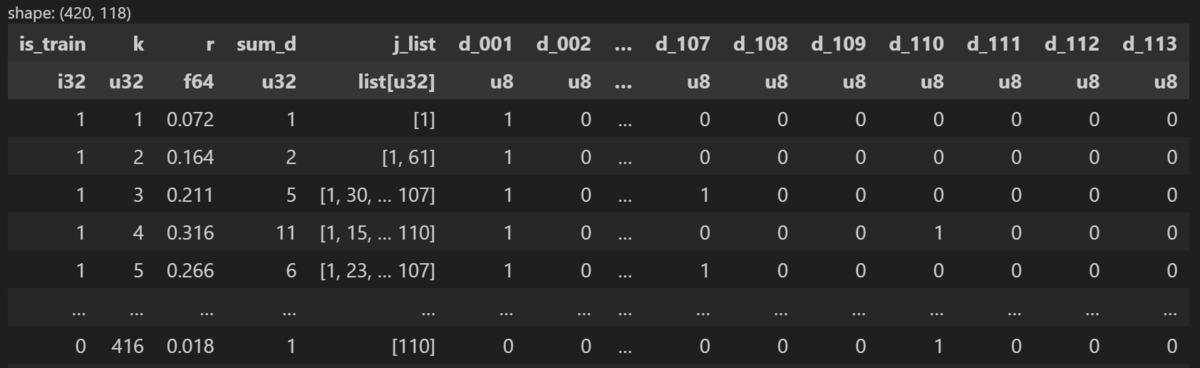
例えば,企業2は番組1と番組61にCMを出稿し,合計のユニークリーチは16.4%となっている。
またこのデータには,学習用データ(数理モデルのパラメータ学習用)と評価用データ(学習したモデルの性能評価用)が含まれる。学習用データは213点,評価用データは92点含まれる。
学習データにおいて,出稿番組数を横軸,合算のユニークリーチを縦軸に取った散布図は,下図のようになる。
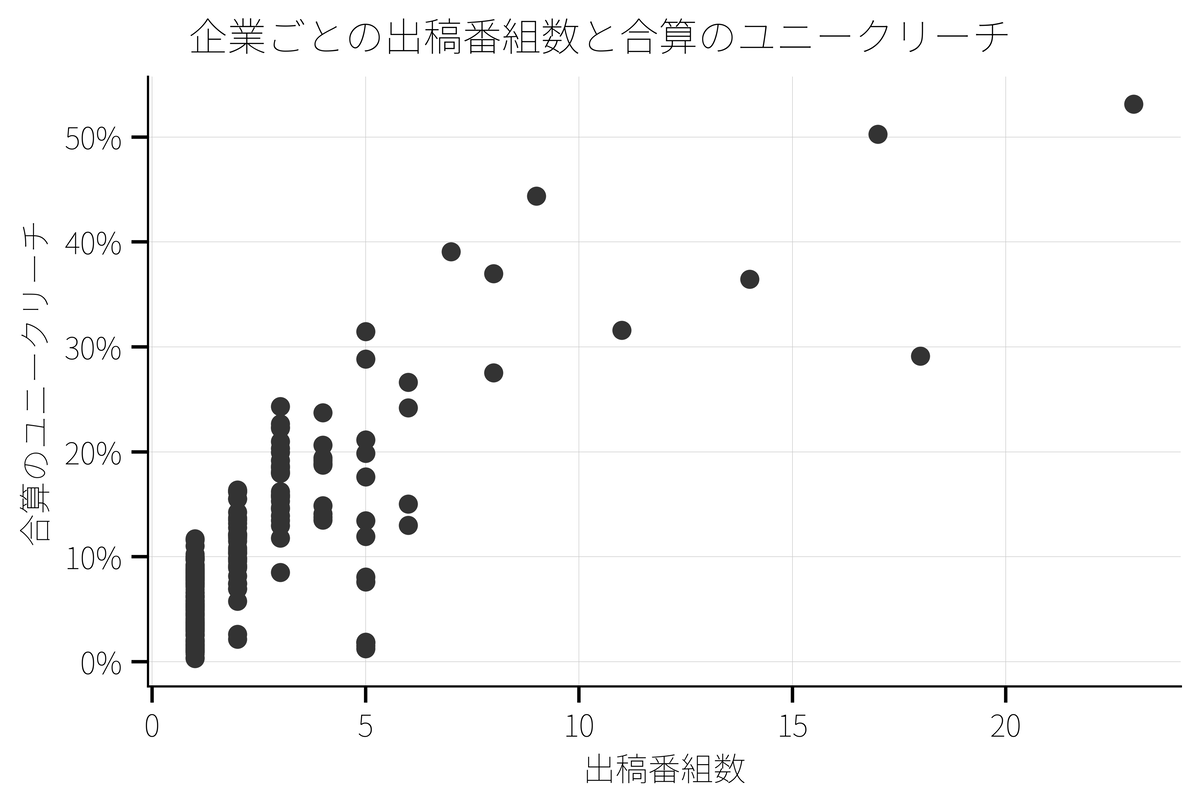
全体的な傾向として,
- 出稿番組数が増えると合算のユニークリーチは増える。
- 同じ出稿番組数でも,合算のユニークリーチにはばらつきがある。
ということが確認できる。
数理モデルの構築
本書では,線形回帰モデル,リッジ回帰モデル,Random Forestによるデータへの当てはめを行ない,いずれも精度が低いことを説明している。
独立性の仮定と補正係数の限界
第4章では,各番組のユニークリーチを組合わせて全体を予測するアプローチをとった。第4章で取ったアプローチは,
- 各番組のCMへの接触には正の相関があると仮定し,補正係数を用いて重複リーチをモデル化する。
という手法を取った。ただしこの手法では,番組の候補が個あると
個の補正係数が必要になる。今回のように番組の候補が113個あると補正係数の数は膨大なものになる。
条件付き独立性の仮定
第4章では,「各番組のCMへの接触は独立ではない」という仮定を置いた。これは,各個人は「テレビ好き」や「テレビ無関心」のような属性をもっており,個人の属性によってCM接触の傾向が異なるためである。
逆に,「テレビ好き」や「テレビ無関心」という属性を固定すれば,番組のCMへの接触が独立だと仮定することは現実的だと言える。
そこで,「テレビ好き」や「テレビ無関心」のような個人のテレビ視聴傾向を表す属性をとして,Law of Iterated Expectations(ILE)*1によって,ユニークリーチの期待値は,
これを細かく確認すると,
- 内側の期待値
は,条件付き確率関数
による期待値
- すなわち,属性
ごとのユニークリーチ
- すなわち,属性
- 外側の期待値
は,確率関数
による期待値
- すなわち属性
- すなわち属性
ということを意味している。
属性が離散値の場合は,最終的に
となる。
個人ごとのCM接触確率への分解
前項ではテレビの視聴傾向の属性を導入したが,適切な属性
を定義して観測することは容易ではない。
そのため属性を,属性の最小単位である個人だと考えてユニークリーチを推定する。
集団の人数を人とすると,
なので,
と表される。ここから個人が番組
のCMに接触する確率
さえ求めれば,合算のユニークリーチを計算できることがわかる。
まとめと感想
今回は,「5章 離散最適化で広告出稿番組を選択する」における前半部分についてまとめた。
本章は,本書における最後の章であり,これまでの章よりもモデル化の手法が複雑になっていた。ただ,条件付き独立性を持ち込むことで,問題を解きやすくするテクニックは興味深かった。LIE(またはTower Property)は,統計検定1級ではおなじみの問題なので,基本的な数理統計学の知識は業務でも活かせると感じた。
応用例 : 製造業における「IoTセンサ配置の最適化」
今回の問題設定はマーケティングにおける問題だったが,製造業における応用例を,ChatGPTを併用して考えてみた。
ビジネス課題
「IoTセンサ配置の最適化」は,限られたセンサ数で製造設備全体の健全性や異常の検知精度を最大化するという,製造業のDX推進において非常に重要なテーマである。
この問題もマーケティングの「番組選択」問題と同様の数理構造を持っており,Tower Propertyや条件付き独立性を応用できる。
今回の事例とのアナロジー
| 要素 | マーケティング(番組選択) | 製造業(センサ配置) |
|---|---|---|
| 対象 | 番組 | センサ設置ポイント |
| 成果指標 |
CMに少なくとも1回接触したか | 設備の異常を1つでも検知できたか |
| 個体属性 |
テレビ視聴傾向(属性) | 設備の稼働パターン・劣化傾向 |
| 接触確率 |
個人 |
設備 |
| コスト |
番組への出稿費用 | センサ設置・通信・保守コスト |
| 制約 | 広告予算 | センサ数・設置工数・帯域制約 |
| 目的 | 合算ユニークリーチ最大化 | 設備群の異常検知能力最大化 |
本書の問題と同様にLIE(Tower Property)を用いることで,設備群全体の異常検出を,設備の属性を固定することで,各センサ
の異常検出は条件付き独立とみなすことができる。
上記の応用例に対する考察
製造業において,開発したシステム全体の保全は重要な課題である。マーケティングの場合,「広告を出稿することで,個人にリーチする」という構造があるが,システム保全においては「センサを配置することで,機器の異常にリーチする」と捉えることができる。
システム保全における施策である「センサによる観測」は,広告を出すことと同様にコストがかかることなので,本書の例は参考になりそうだと感じた。
本記事を最後まで読んでくださり,どうもありがとうございました。

*1:数理統計学の教科書に出てくるTower Propertyと同等である。
