jiku log

データサイエンスの核心を掴む : 学びと発見の記録

「ベイズ最適化」を読む ~第3章 ベイズ最適化のアルゴリズム ⑤トンプソン抽出獲得関数(2)~

はじめに

データを使って仮説の生成と検証を行なうための方法であるベイズ最適化を学ぶために,今村秀明・松井孝太 著「ベイズ最適化 ー適応的実験計画の基礎と実践ー」を読むことにした。

本記事は,「第3章 ベイズ最適化のアルゴリズム」における,トンプソン抽出獲得関数に関する読書メモである。

  • 本書の紹介ページ

www.kindaikagaku.co.jp

3.5 トンプソン抽出獲得関数

ガウス過程の疎スペクトル近似

トンプソン抽出獲得関数を素朴に計算する方法では,計算量が多くなることが問題であった。これは,獲得関数 \alpha_{TS}(\mathbfit{x})を最大化するような \mathbfit{x}を見つけようとした際に, \mathbfit{x}が存在する領域 \mathcal{X}を \Delta分割して離散化したたためである。

本節では,ガウス過程の計算量を減らすためのテクニックである,ガウス過程の疎スペクトル近似について説明している。


ガウス過程の疎スペクトル近似とは,不変カーネル(Stationary kernel)を用いたガウス過程に用いることができる近似である。なお不変カーネルとは,カーネル関数 k(x, y)が |x- y|の関数になるようなカーネル関数である。
ガウス過程の疎スペクトル近似を用いることにより, O(n^3)だった計算量を O(nm^2) (m \lt n)まで減らすことができる。


詳細な導出は本書に記載している通りであるが,ポイントは


 \begin{align}
k(\mathbfit{x}, \mathbfit{x}) &= \phi(\mathbfit{x})^T \phi(\mathbfit{y}) \\ \\ 
\phi(\mathbfit{x}) &\in \mathbb{R}^m, m \lt n \\ 
\end{align}

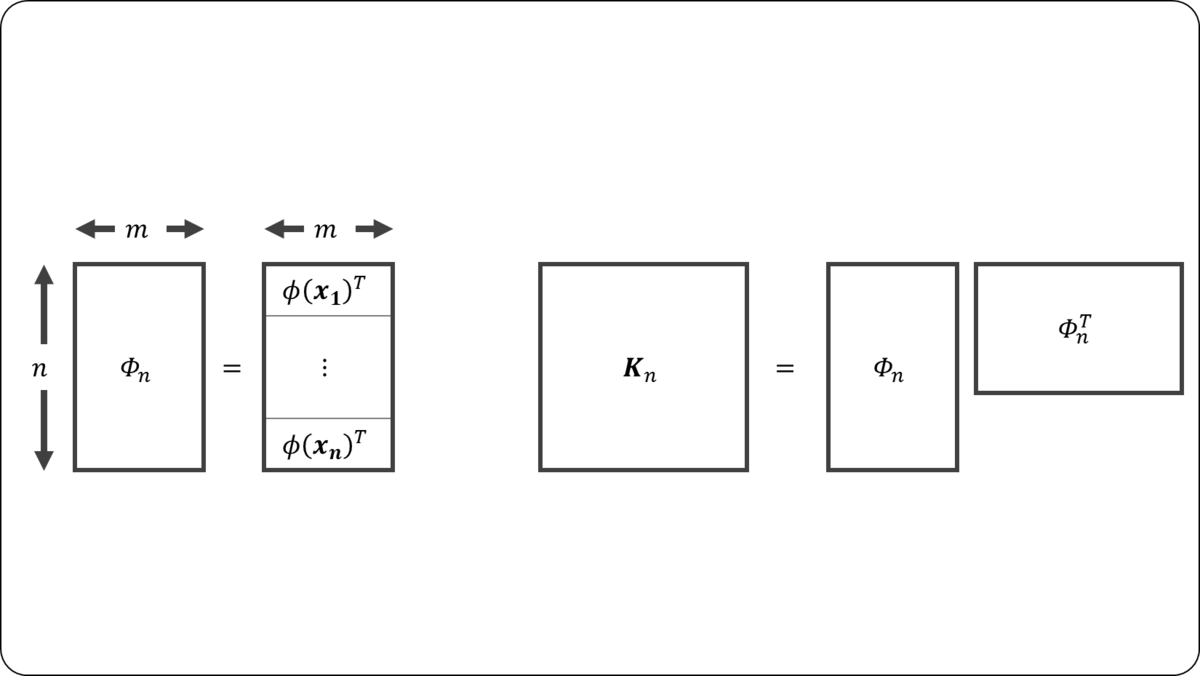
となるような \phiを構成することである。なお, m \lt n \ll  \Deltaであるとする。またこの \phiを用いて,


 \begin{align}
\Phi = 

\begin{bmatrix}
  \phi(\mathbfit{x}_1)^T \\
  \vdots \\
  \phi(\mathbfit{x}_n)^T 
\end{bmatrix}

\in \mathbb{R}^{n \times m} \\
\end{align}

とする。この \Phiを用いると,


 \begin{align}
\Phi \Phi^T &= 

\begin{bmatrix}
  \phi(\mathbfit{x}_1)^T \\
  \vdots \\
  \phi(\mathbfit{x}_n)^T 
\end{bmatrix}

\begin{bmatrix}
  \phi(\mathbfit{x}_1) &
  \cdots &
  \phi(\mathbfit{x}_n) 
\end{bmatrix}

\\ \\ 

&=

\begin{bmatrix}
  \phi(\mathbfit{x}_1)^T \phi(\mathbfit{x}_1) & \cdots & \phi(\mathbfit{x}_1)^T \phi(\mathbfit{x}_n) \\
  \vdots & \ddots & \vdots \\
  \phi(\mathbfit{x}_n)^T \phi(\mathbfit{x}_1) & \cdots & \phi(\mathbfit{x}_n)^T \phi(\mathbfit{x}_n) \\
\end{bmatrix}

= \mathbfit{K}_n 

\in \mathbb{R}^{n \times n} \\
\end{align}

となる。


 \phiを用いて目的関数 fの事後分布 \mathcal{GP}(\mu_n, \kappa_n)の平均関数とカーネル関数を近似すると,


 \begin{align}
\mu_n(\mathbfit{x}) 
&= \mathbfit{k}_n (\mathbfit{x})^T (\mathbfit{K}_n + \sigma^2 \mathbfit{I}_n)^{-1} \mathbfit{y}_n \\ \\
&= 
\phi(\mathbfit{x})^T \Phi_n^T (\Phi_n \Phi_n^T  + \sigma^2 \mathbfit{I}_n)^{-1} \mathbfit{y}_n \\ \\

\kappa_n(\mathbfit{x}, \mathbfit{x'}) 
&= k(\mathbfit{x}, \mathbfit{x'}) - \mathbfit{k}_n (\mathbfit{x})^T (\mathbfit{K}_n + \sigma^2 \mathbfit{I}_n)^{-1} \mathbfit{k}_n (\mathbfit{x}) \\ \\
&= \phi(\mathbfit{x})^T (\mathbfit{I}_m - \Phi_n^T  (\Phi_n \Phi_n^T  + \sigma^2 \mathbfit{I}_n)^{-1}  \Phi_n )  \phi(\mathbfit{x}') \\

\end{align}

となる。


ここで,行列を扱いやすくするために,Woodburyの恒等式を用いる。


 \begin{align}
\Psi_n^{-1} = \mathbfit{I}_m - \Phi_n^T  (\Phi_n \Phi_n^T  + \sigma^2 \mathbfit{I}_n)^{-1}  \Phi_n \\
\end{align}

とすると,Woodburyの恒等式を用いて,


 \begin{align}
\Psi_n = \mathbfit{I}_m + \frac{1}{\sigma^2} \Phi_n^T   \Phi_n  \in \mathbb{R}^{m \times m}  \\
\end{align}

となる。

以上より,


 \begin{align}
\mu_n(\mathbfit{x}) 
&\approx \frac{1}{\sigma^2}  \phi(\mathbfit{x})^T \Psi_n^{-1} \Phi_n^T \mathbfit{y}_n  \equiv  \tilde{\mu}_n(\mathbfit{x})  \\ \\

\kappa_n(\mathbfit{x}, \mathbfit{x'}) 
&\approx \phi(\mathbfit{x})^T \Psi_n^{-1} \phi(\mathbfit{x}') \equiv \tilde{\kappa}_n(\mathbfit{x}, \mathbfit{x'})  \\
\end{align}

となる。


長くなってしまったがポイントは,近似する前は (\mathbfit{K}_n + \sigma^2 \mathbfit{I}_n) \in \mathbb{R}^{n \times n}の逆行列を計算するため計算量が O(n^3)かかっていたのに対して,近似後は \Psi \in \mathbb{R}^{m \times m}の逆行列を計算するため計算量が O(m^3)まで小さくなっているということである。

疎スペクトル近似を用いた計算方法

本節では,前節で導入したガウス過程の疎スペクトル近似を用いて,トンプソン抽出獲得関数を計算する方法を説明している。

目的関数の定義域 \mathcal{X}を \Delta個の有限な点で近似すると,事後分布からの関数のサンプリングは,有限個の点集合上での関数値のサンプリングで近似される。


 \begin{align}
\mathcal{X} &\approx \{  \mathbfit{x}_i \}_{i=1}^\Delta  \\ \\
f^{(n)}  &\approx  \tilde{f}^{(n)} : \mathbfit{x} \mapsto y_i \\ \\
(y_1, \cdots, y_{\Delta}) &\sim \mathcal{N}(\mathbfit{\mu}_n , \mathbfit{\kappa}_n)  \\
\end{align}

ここで,ガウス過程の疎スペクトル近似を導入する。


 \begin{align}
(y_1, \cdots, y_{\Delta}) &\sim \mathcal{N}(\tilde{\mathbfit{\mu}}_n , \tilde{\mathbfit{\kappa}}_n)  \\ \\
\tilde{\mathbfit{\mu}}_n & \in \mathbb{R}^{\Delta}, \tilde{\mathbfit{\kappa}}_n \in \mathbb{R}^{\Delta \times \Delta} \\
\end{align}

とする。ただし,


 \begin{align}
\tilde{\mathbfit{\mu}}_n (i) &= \frac{1}{\sigma^2}  \phi(\mathbfit{x}_i)^T \Psi_n^{-1} \Phi_n^T \mathbfit{y}_n  \\ \\
\tilde{\mathbfit{\kappa}}_n (i, j) &= \phi(\mathbfit{x}_i)^T \Psi_n^{-1} \phi(\mathbfit{x}_j) \\
\end{align}

である。

さらに, \Phi_{\Delta} = (\phi(\mathbfit{x}_1)^T  \cdots  \phi(\mathbfit{x}_\Delta)^T) ^T \in \mathbb{R}^{\Delta \times m}を導入すると,


 \begin{align}
\tilde{\mathbfit{\mu}}_n  &= \frac{1}{\sigma^2}  \Phi_{\Delta} \Psi_n^{-1} \Phi_n^T \mathbfit{y}_n  \\ \\
\tilde{\mathbfit{\kappa}}_n  &= \Phi_{\Delta} \Psi_n^{-1} \Phi_{\Delta}^T \\
\end{align}

と書き表すことができる。


トンプソン抽出獲得関数の最大値を得るには (y_1, \cdots, y_{\Delta}) を得ることになるが,そのためには, \mathcal{N}(\tilde{\mathbfit{\mu}}_n , \tilde{\mathbfit{\kappa}}_n) からサンプリングすればよい。このサンプリングを実現するには,正規分布の線形変換を用いて,以下のように行なう。

  1.  \mathbfit{\theta} \in \mathbb{R}^mを \mathcal{N}(\frac{1}{\sigma^2}  \Phi_{\Delta} \Psi_n^{-1} \Phi_n^T  \mathbfit{y}_n,  \Psi_n^{-1})からサンプリングする。
  2.  y_i = \phi(\mathbfit{x}_i) \mathbfit{\theta} という線形変換を行なう。


線形変換を用いる理由は,正規分布からのサンプリングの計算量を減らすためである。
 \mathbfit{\theta}は \mathbfit{\theta} \in \mathbb{R}^mであるが, \tilde{\mathbfit{\mu}}_nは \tilde{\mathbfit{\mu}}_n \in \mathbb{R}^{\Delta}なので, \mathbfit{\theta}のサンプリングの方が計算量が少ないのである。


この近似により,もともと O(\Delta^3)だった計算量が O(nm^2 + m\Delta)まで削減できたが,それでもなお計算量は大きい。
これは, \Deltaはもともと連続的な \mathbfit{x}の定義域を離散化するために導入されたものであるが,この \Deltaは一般的に大きな値になるためである。

そのため次節では,定義域を有限個の点集合で離散化することなく,すなわち \Deltaを登場させることなく,トンプソン抽出獲得関数を近似する方法を説明している。

疎スペクトル近似を用いた効率的な計算方法

あらためて (y_1, \cdots, y_{\Delta}) を見直してみる。

  1.  \mathbfit{\theta} \in \mathbb{R}^mを \mathcal{N}(\frac{1}{\sigma^2}  \Phi_{\Delta} \Psi_n^{-1} \Phi_n^T  \mathbfit{y}_n,  \Psi_n^{-1})からサンプリングする。
  2.  y_i = \phi(\mathbfit{x}_i) \mathbfit{\theta} という線形変換を行なう。

すなわち \mathbfit{\theta}は,定義域を \Delta個に分割した \mathbfit{x}_1, \cdots, \mathbfit{x}_{\Delta}とは無関係である。
そのため \mathbfit{\theta}をサンプリングした後に, y = \phi(\mathbfit{x})^T \mathbfit{\theta}とすれば,目的関数値 yは定まる。
したがって,


 \begin{align}
f^{(n)} \approx \phi(\mathbfit{x})^T \mathbfit{\theta} \\
\end{align}

と近似することができる。

 \alpha_{\mathrm{TS}} = -f^{(n)}であるので,


 \begin{align}
\alpha_{\mathrm{TS}} \approx - \phi(\mathbfit{x})^T \mathbfit{\theta} \\
\end{align}

となる。 \phiは解析的に計算できるため,右辺は勾配法などを用いて直接最大化ができる。

計算量は,勾配法の反復を T回行なうとすれば,全体で O(nm^2 + Tm)程度になる。 T \ll \Deltaとすれば,前節の方法に比べて大幅に計算時間が削減できることが分かる。

獲得関数の性質

トンプソン抽出は,ベイズ最適化の文脈ではそれほど使われてはいない。また次元数が大きくなると性能が悪化することが知られている。

ただし,途中で説明した「目的関数事後分布 \mathcal{GP}(\mu_n, \kappa_n)から関数をサンプリングする計算量を O(nm^2)にする」というテクニックは,近年のベイズ最適化の手法においてよく用いられる手法である。

まとめと感想

今回は,「第3章 ベイズ最適化のアルゴリズム」のうち, トンプソン抽出獲得関数の計算量を低減するためのテクニックについて学んだ。

本節は結構込み入った内容であるため,全体像を整理した。
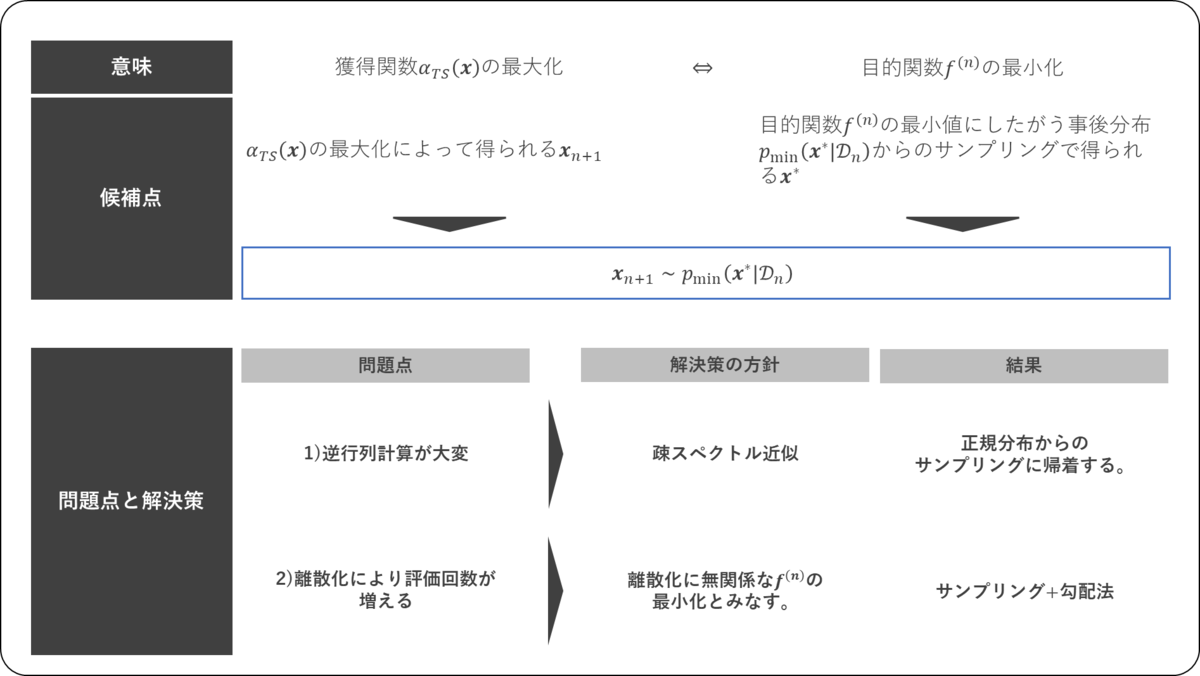

ガウス過程における目的関数の事後分布計算は,逆行列計算を含むためにもともと計算量が多くなる。また,連続的な定義域 \mathcal{X}を \Delta個に分割して離散化することも計算量の増加の原因となる。

これらの計算量の増加を回避するために,疎スペクトル近似を用いたり,定義域の離散化を用いないように獲得関数を解釈しなおしたりすることは,まるで手品を見ているようで鮮やかであった。これらの手法はベイズ最適化においてよく用いられるそうなので,しっかり習熟していきたい。


本記事を最後まで読んでくださり,どうもありがとうございました。