jiku log

データサイエンスの核心を掴む : 学びと発見の記録

「スモールデータ解析と機械学習」を読む ~第5章 分類問題と不均衡データ問題 ①線形判別分析~

はじめに

藤原 幸一 著「スモールデータ解析と機械学習」は,サンプル数が少ない状況でのモデル構築や予測精度の確保,統計的な不確実性の扱い方など,現場で直面する悩みに直結する理論と実践がコンパクトにまとまっている。製造業のデータ解析において「少ないデータだから仕方ない」と諦めるのではなく,「少ないからこそできる工夫」を身につけるためにこの本を読み,その学びをブログで共有しようと思う。

本記事は,「第5章 分類問題と不均衡データ問題」における,線形判別分析に関する読書メモである。

第5章 分類問題と不均衡データ問題

前章では主に回帰問題を扱っていたが,本章では回帰問題と並んで機械学習の典型的タスクである分類問題を対象とする。
特に分類問題において,データのクラスのサンプル数が著しく偏っている不均衡データについても扱っている。

5.2 線形判別分析

分類問題で用いられる最もシンプルな方法が,線形判別分析(Linear Discriminant Analysis; LDA)*1である。

LDAは,2つのクラスを最も良く識別できる直線で2クラス分類を行なう方法である。

基本的な考え方

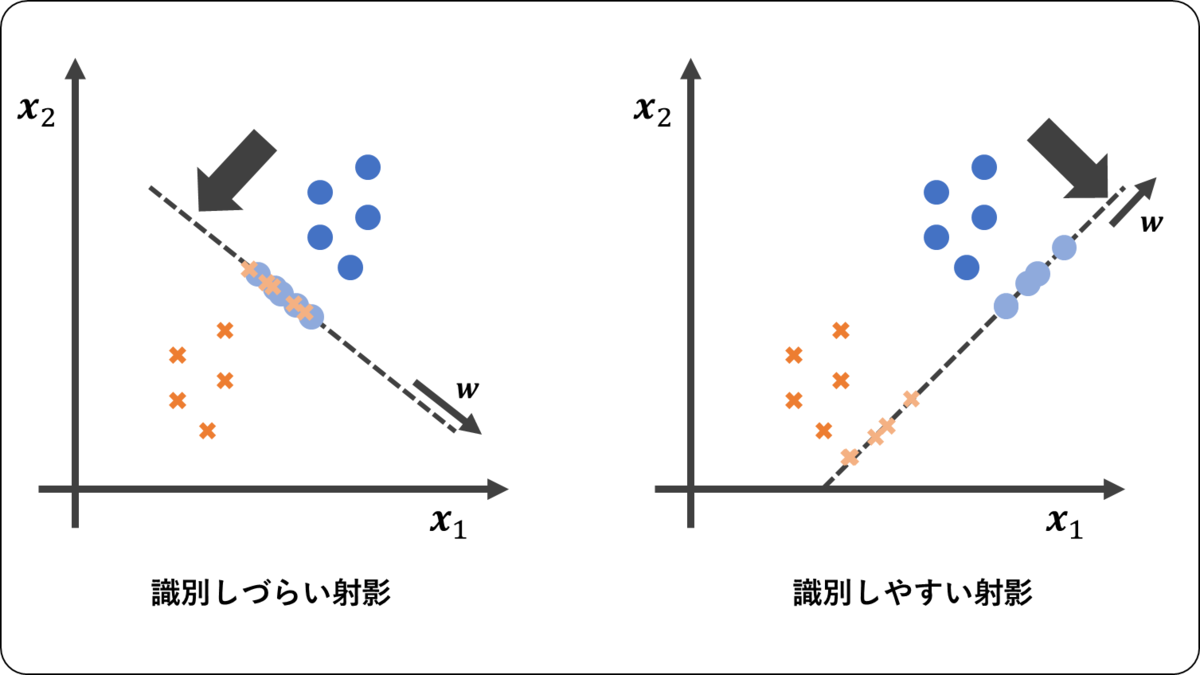
サンプル \mathbfit{x}_nが1次元や2次元の場合は,このような直線は視覚的に判断しやすいが,高次元の場合は判断が難しくなる。そのため,サンプル \mathbfit{x}_n \in \mathbb{R}^Mを射影軸 \mathbfit{w}を用いて


 \begin{align}
y_n = \mathbfit{w}^T \mathbfit{x}_n \\ \\
\end{align}
のように射影して1次元に変換してから識別境界を求める。

射影軸wの決め方

射影軸 \mathbfit{w}は,適当に決めると,射影しても2つのクラスが分離できないが,うまく決めると射影後に旨く分離することができるようになる。この射影軸 \mathbfit{w}は,データから学習することになる。

射影軸と分離のしやすさ


射影軸の選び方は,クラス間変動とクラス内変動に基づくものである。
2つのクラス C_1, C_2のサンプル数がそれぞれ N_1, N_2であるとする。各クラスの平均はそれぞれ,


 \begin{align}
\mathbfit{m}_1 = \frac{1}{N_1} \sum_{n \in C_1} \mathbfit{x}_n \\ \\
\mathbfit{m}_2 = \frac{1}{N_2} \sum_{n \in C_2} \mathbfit{x}_n \\ \\
\end{align}
となる。

クラス内変動 s^2は,


 \begin{align}
&s^2 = s_1^2 + s_2^2 \\ \\
&s_1^2 = \sum_{n \in C_1} (\mathbfit{w}^T \mathbfit{x}_n - \mathbfit{w}^T \mathbfit{m}_1)^2 \\ \\
&s_2^2 = \sum_{n \in C_2} (\mathbfit{w}^T \mathbfit{x}_n - \mathbfit{w}^T \mathbfit{m}_2)^2 \\ \\
\end{align}
となる。これを変形すると,

 \begin{align}
&s^2 =  \mathbfit{w}^T \mathbfit{S}_W \mathbfit{w} \\ \\
&\mathbfit{S}_W = \sum_{n \in C_1} (\mathbfit{x}_n - \mathbfit{m}_1)(\mathbfit{x}_n - \mathbfit{m}_1)^T + \sum_{n \in C_2} (\mathbfit{x}_n - \mathbfit{m}_2)(\mathbfit{x}_n - \mathbfit{m}_2)^T \\ \\
\end{align}

またクラス間変動は,


 \begin{align}
\mathbfit{S}_B = (\mathbfit{m}_1 - \mathbfit{m}_2)(\mathbfit{m}_1 - \mathbfit{m}_2)^T \\ \\
\end{align}
として, \mathbfit{w}^T \mathbfit{S}_B \mathbfit{w}となる。


LDAの学習基準は,2つのクラスを出来るだけ分離するということであるので,

  • クラス間変動 \mathbfit{w}^T \mathbfit{S}_B \mathbfit{w}を最大化する
  • クラス内変動 \mathbfit{w}^T \mathbfit{S}_W \mathbfit{w}を最小化する

ということになるので,目的関数は


 \begin{align}
J(\mathbfit{w}) = \frac{\mathbfit{w}^T \mathbfit{S}_B \mathbfit{w}}{\mathbfit{w}^T \mathbfit{S}_W \mathbfit{w}} \\ \\
\end{align}
として,これを \mathbfit{w}について最大化する問題となる。

5.3 線形判別分析とレイリー商

上記の J(\mathbfit{w})のような形の式をレイリー商と呼ぶ。本節では,LDAにおける最大化問題を,レイリー商の性質を用いて求める方法を説明している。


上記の最大化問題では, \mathbfit{w}の大きさに関する制約がない。そのため,


 \begin{align}
\mathbfit{w}^T \mathbfit{S}_W \mathbfit{w} = 1 \\ \\
\end{align}
と置く。このようにすると,上記の最大化問題は,

 \begin{align}
\max_{\mathbfit{w}} \quad & \mathbfit{w}^T \mathbfit{S}_B \mathbfit{w} \\ \\
\mathrm{s. t. } \quad & \mathbfit{w}^T \mathbfit{S}_W \mathbfit{w} = 1 \\ \\
\end{align}
となる。

これは,制約付き最大化問題なので,ラグランジュの未定乗数法により目的関数は,


 \begin{align}
J'(\mathbfit{w}) = \mathbfit{w}^T \mathbfit{S}_B \mathbfit{w} - \lambda (\mathbfit{w}^T \mathbfit{S}_W \mathbfit{w} - 1) \\ \\
\end{align}
となる。

これを微分して0と置き式変形すると,最終的には


 \begin{align}
\mathbfit{S}_W^{-1} \mathbfit{S}_B \mathbfit{w} = \lambda \mathbfit{w} \\ \\
\end{align}
という固有値問題が得られる。

まとめと感想

今回は,「第5章 分類問題と不均衡データ問題」における,線形判別分析についてまとめた。

LDAは基本的な手法だが,実務においても依然として学ぶ価値が大きいと感じた。

LDAにおける学習基準である「クラス間分離とクラス内のまとまりを最大化する」という基準は直感的で,製造現場の品質管理や異常検知において説明しやすい。ブラックボックス化しやすい深層学習と違い,「なぜこの判定になったのか」を議論する基盤になる。

また,製造業のデータ解析では,本章が扱う「不均衡データ問題」には頻繁に直面する。この場合,LDAを単純に適用すると境界が偏る可能性があるため,事前確率やコストを調整する工夫が必要になるが,LDAは「ベースライン」としてまず理解すべき手法だと再確認した。

LDAは古典的な手法ながら,分類問題の考え方の基本を押さえるのに非常に適している。製造業のデータサイエンティストとしても,「高度な手法を使う前に,まずはLDAでデータの分離可能性を確認する」というアプローチは有効だと感じた。


本記事を最後まで読んでくださり,どうもありがとうございました。

*1:なお機械学習の文脈でLDAというと,トピックモデルの1つである「潜在ディリクレ配分法」(Latent Dirichlet Allocation)の略称もLDAなので,注意が必要である。